40 · Cấp phát, chia sẻ và thu hồi KV block
Nguồn: fanout.sh / inference-eng / 08-04 · ~5 phút
Ghi chú
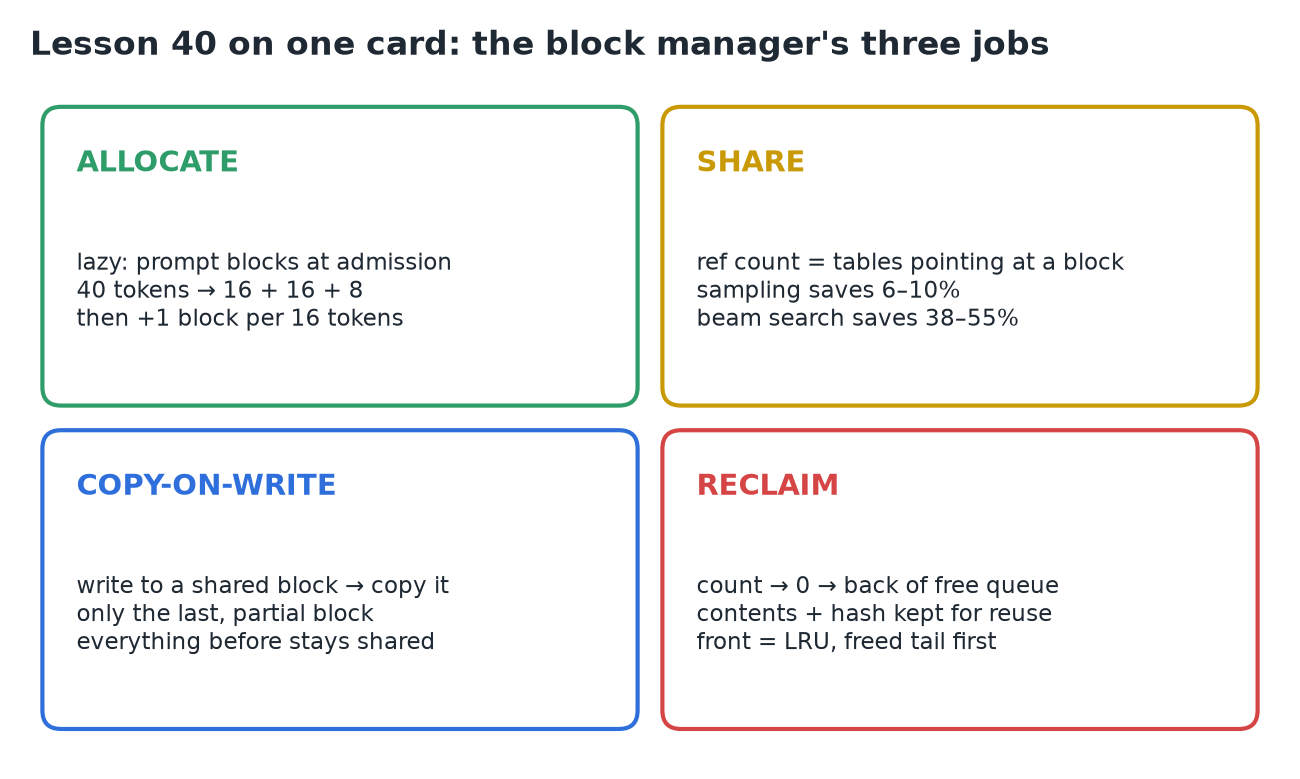
Block và block table cho engine một block manager nhỏ sở hữu mọi KV block trên GPU và làm ba việc. Nó cấp phát lười (lazily): đủ block cho prompt, rồi thêm một block mỗi 16 token. Nó chia sẻ block qua reference count, chỉ chép một block dùng chung khi có ai ghi vào nó (copy-on-write); chia sẻ tiết kiệm 6–10% bộ nhớ KV với parallel sampling và 38–55% với beam search trong paper vLLM. Nó thu hồi các block có số đếm về 0 vào một free queue, và trong vLLM nó giữ lại nội dung để một request sau có cùng token dùng lại được.
1. Cấp phát: một cách lười biếng
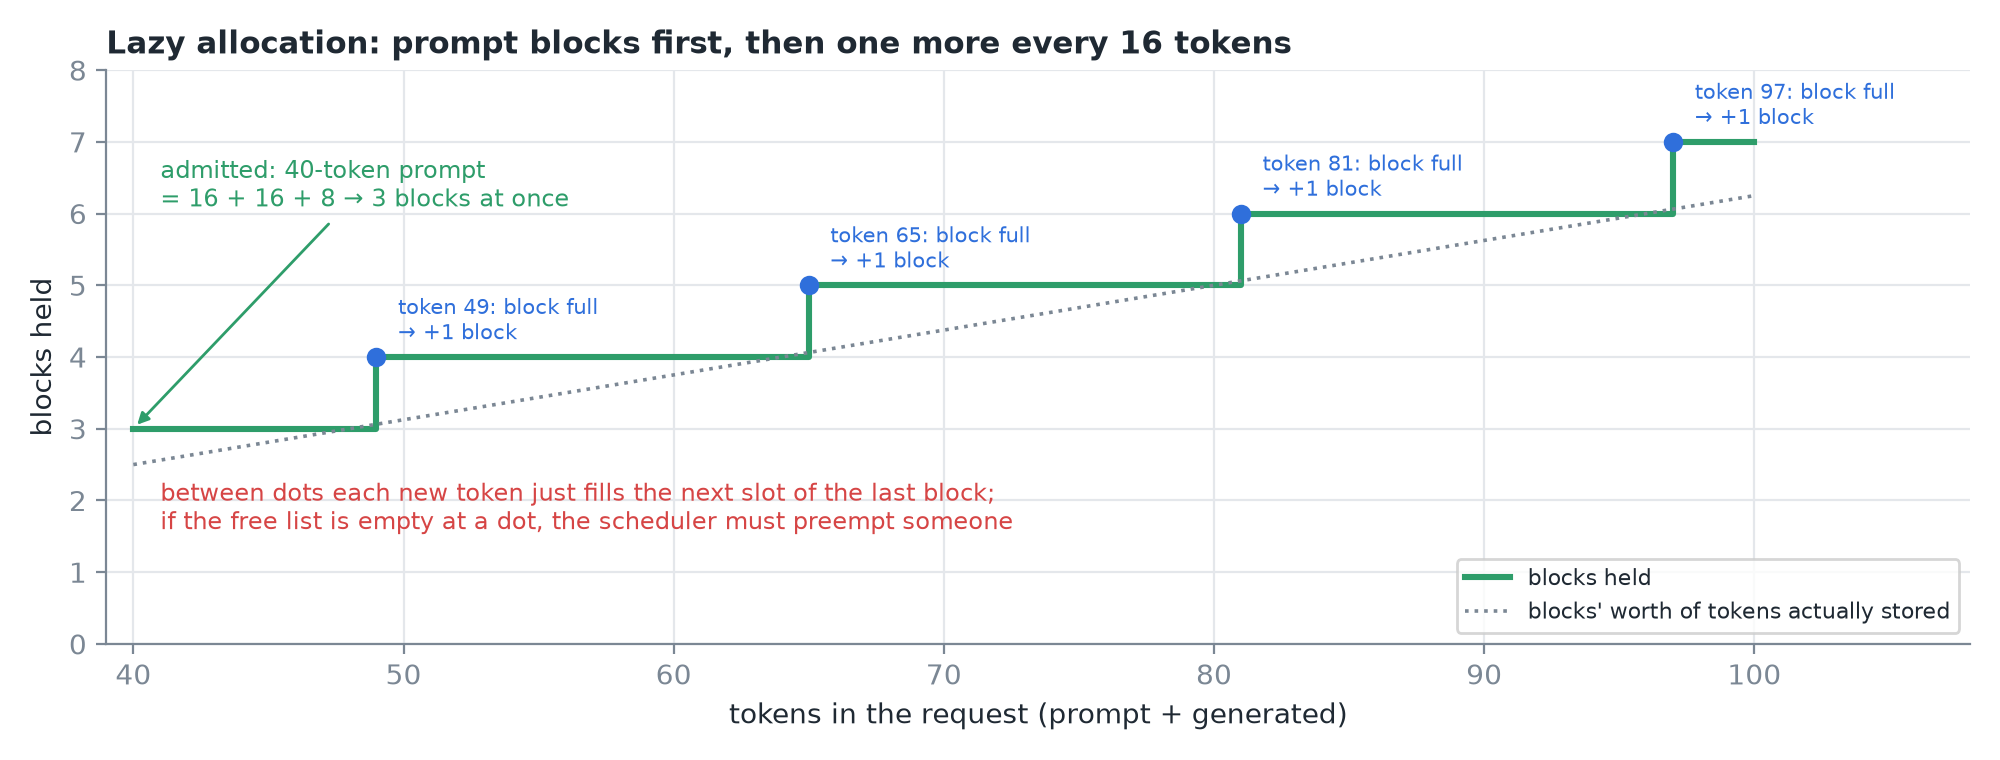 Một prompt 40 token nhận 3 block lúc được nhận vào; sau đó chỉ thêm block khi block cuối đầy.
- Lúc nhận vào: vừa đủ block cho prompt. 40 token = 16 + 16 + 8 → 3 block.
- Sau đó mỗi token mới lấp slot kế tiếp của block cuối; chỉ khi một block đầy mới cần block mới.
- Vì vậy một request xin block mỗi 16 token một lần, không phải mỗi token, và không bao giờ xin cho token nó chưa sinh ra.
- Nếu lúc đó không còn block trống, scheduler phải preempt ai đó.
◆ Với 40 token prompt cộng 1.000 token sinh ra:
2. Chia sẻ: reference count và copy-on-write
Hai câu trả lời khác nhau cho cùng một prompt (parallel sampling) có KV giống hệt nhau cho phần prompt. Thay vì lưu hai lần, cả hai block table trỏ vào cùng các block vật lý, và mỗi block giữ một reference count: có bao nhiêu bảng trỏ vào nó.
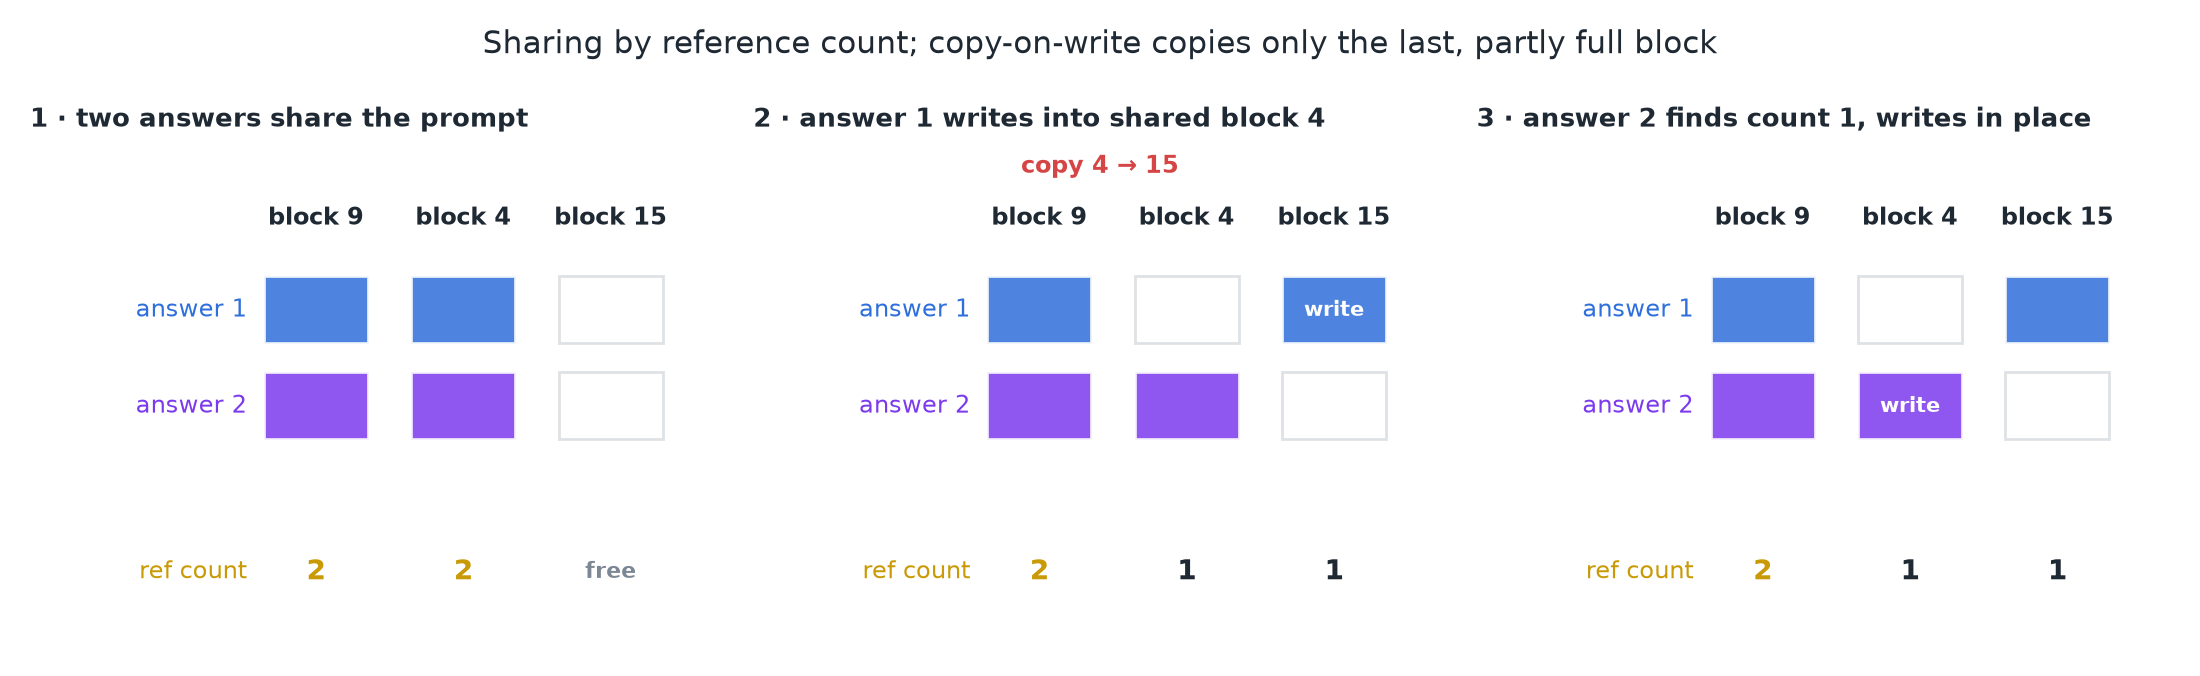 Cả hai câu trả lời bắt đầu trên block 9 và 4 (mỗi block đếm 2). Lần ghi đầu tiên của câu trả lời 1 vào block 4 đầy một phần kích hoạt một bản chép sang block 15; sau đó câu trả lời 2 ghi thẳng vào block 4.
- Câu trả lời 1 muốn ghi token mới đầu tiên vào block prompt cuối, vốn chưa đầy. Nhưng nó đang được chia sẻ, và câu trả lời 2 vẫn cần bản gốc.
- Vì vậy manager chép đúng một block đó sang một block mới, trỏ câu trả lời 1 vào bản chép, và giảm số đếm của block cũ xuống 1.
- Giờ câu trả lời 2 thấy số đếm 1 và ghi thẳng vào. Đây là copy-on-write, cùng mẹo mà hệ điều hành dùng khi một process fork.
- Chỉ block cuối, đầy một phần mới bị chép; mọi thứ trước nó vẫn được chia sẻ suốt phần còn lại của request.
◆ Một lần chép với Llama 3.1 8B chỉ là một block, 16 × 128 KiB = 2 MiB, dù prompt chung dài tới đâu.
Beam search
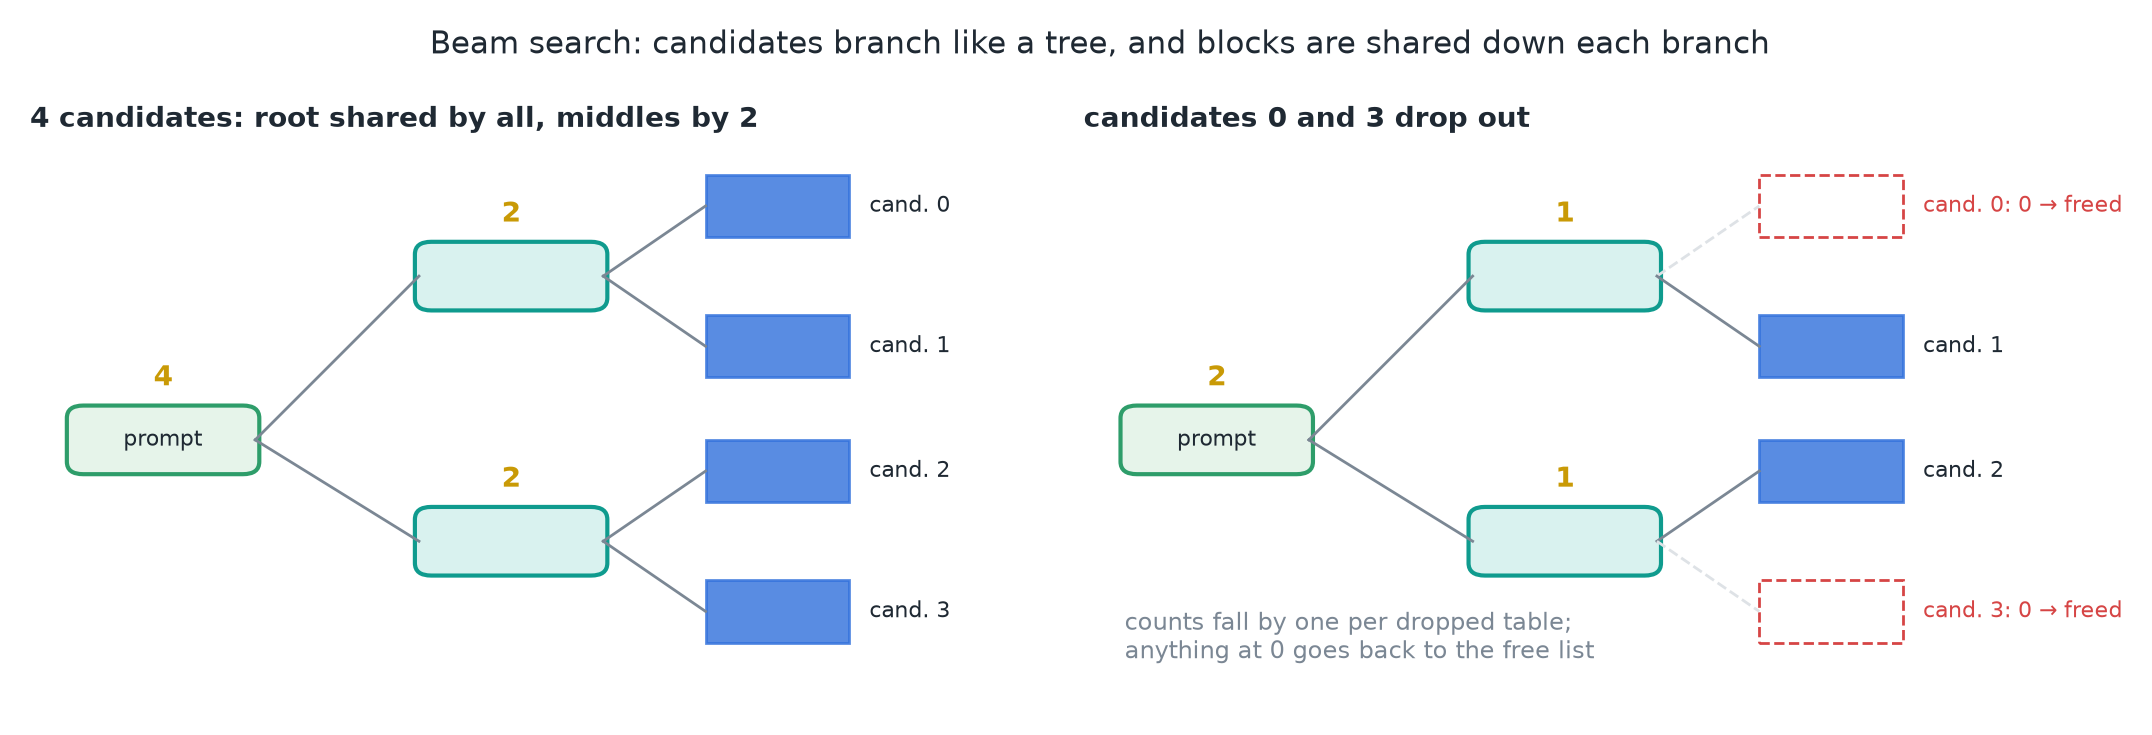 Block gần gốc được mọi ứng viên chia sẻ, block sâu hơn chỉ được các ứng viên đi theo nhánh đó chia sẻ. Khi một ứng viên bị loại, mọi block trên đường đi của nó mất một số đếm.
- Beam search giữ nhiều ứng viên câu trả lời cùng sống, rẽ nhánh từ nhau như một cái cây.
- Khi một ứng viên rời khỏi beam, số đếm các block của nó giảm xuống, và block nào về 0 thì được giải phóng.
Cảnh báo
Khung hình trong video giữ block gốc ở 4 sau khi ứng viên 0 và 3 bị loại. Chỉ còn hai block table trỏ vào nó, nên số đếm phải là 2, như vẽ ở đây.
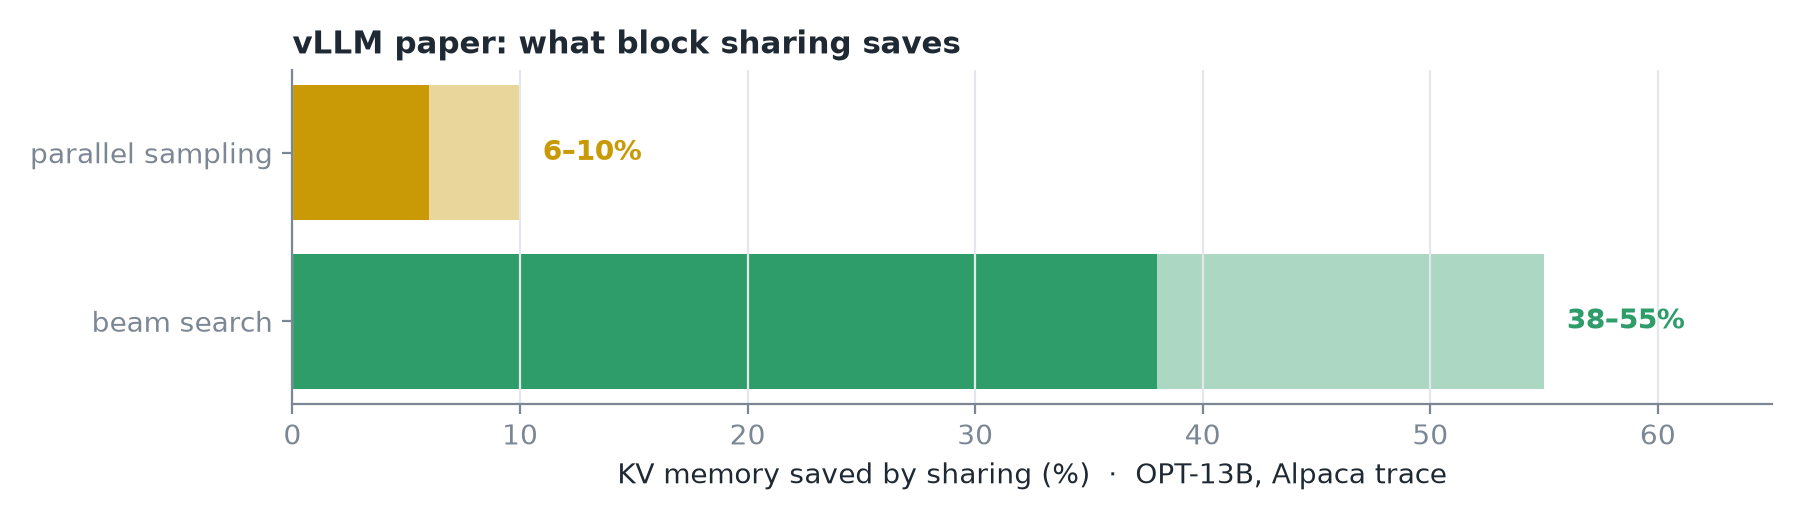 Bộ nhớ KV tiết kiệm được nhờ chia sẻ trong paper vLLM (OPT-13B, trace Alpaca). ◆ Beam search tiết kiệm nhiều hơn vì các ứng viên chia sẻ cả nhánh, không chỉ prompt.
- Cùng cơ chế đó cho phép những request hoàn toàn khác nhau chia sẻ một prefix chung, như một system prompt dài. Đó là prefix caching.
3. Thu hồi: giải phóng khi về 0, nhưng giữ nội dung
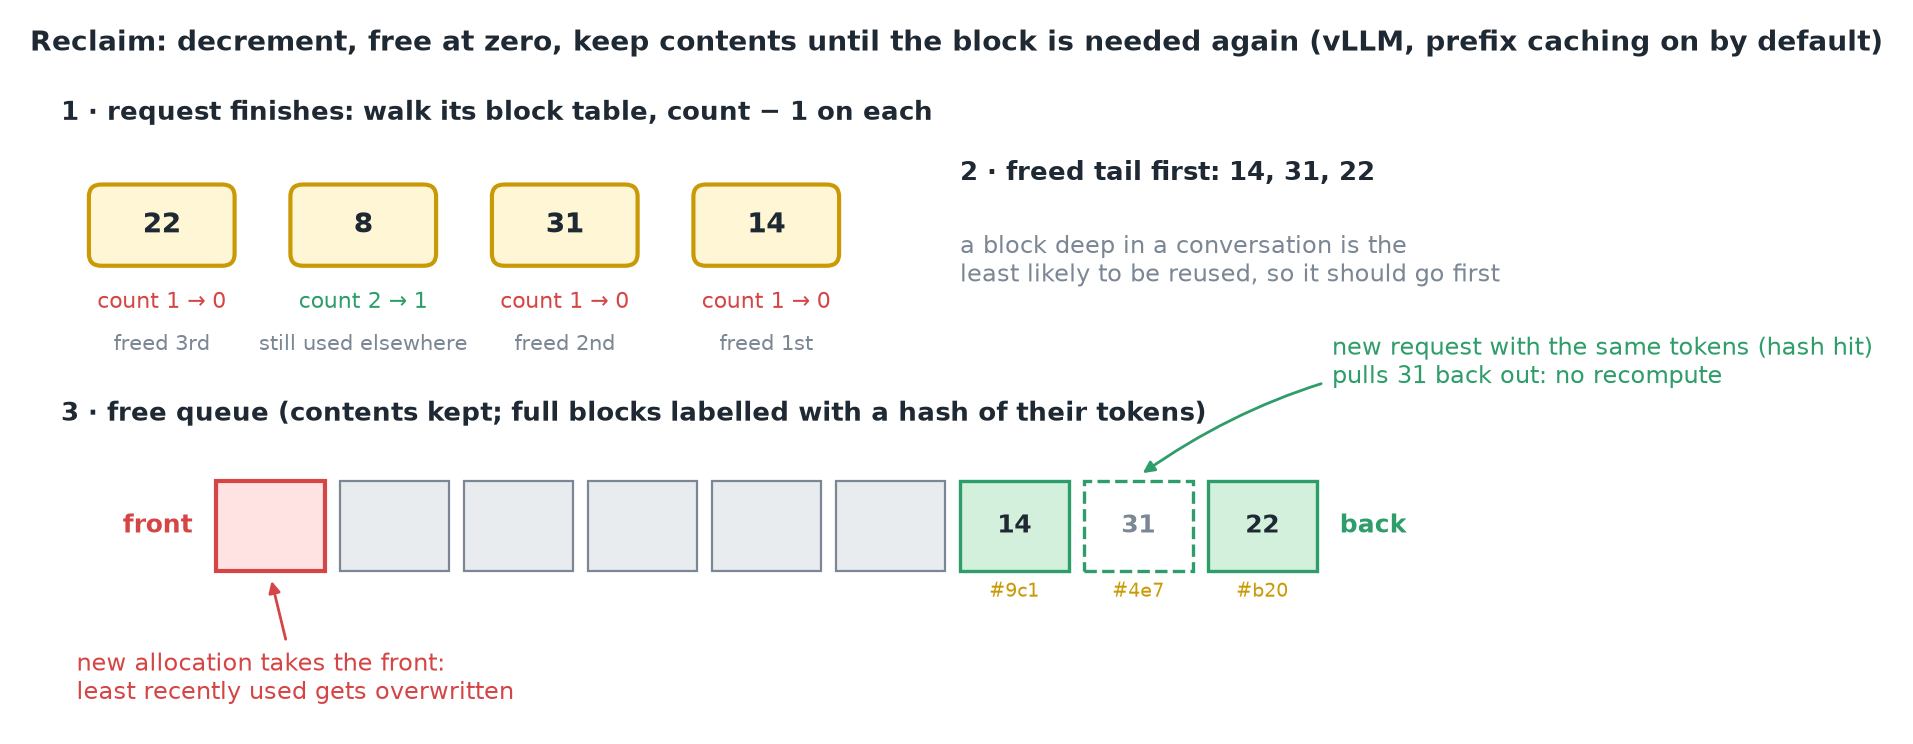 Một request đã xong với bảng 22, 8, 31, 14. Block 8 vẫn được dùng ở nơi khác; ba block còn lại vào cuối free queue. Nhãn hash mang tính minh hoạ.
- Khi một request xong, manager duyệt block table của nó và giảm số đếm của từng block. Block nào về 0 thì trở về free queue.
- Trong vLLM, khi bật prefix caching (mặc định), block được giải phóng không bị xoá trắng. Nó vào cuối free queue vẫn giữ key và value, và một block đầy được gắn nhãn bằng hash của các token trong nó.
- Một request mới có cùng token có thể lấy ngay block đó ra và bỏ qua việc tính lại.
- Cấp phát mới lấy block từ đầu hàng, nên các block lâu nhất không được dùng (LRU) bị ghi đè trước.
- Các block của một request được giải phóng từ đuôi trước, vì block nằm sâu trong một cuộc hội thoại là ít khả năng được dùng lại nhất.
Quan trọng
Một block đã giải phóng chỉ là ứng viên để ghi đè. Cho tới khi có gì đó lấy nó khỏi đầu hàng, nó là một cache hit miễn phí.
4. Tóm tắt