41 · Preemption, tính lại và áp lực KV
Nguồn: fanout.sh / inference-eng / 08-05 · ~5 phút
Ghi chú
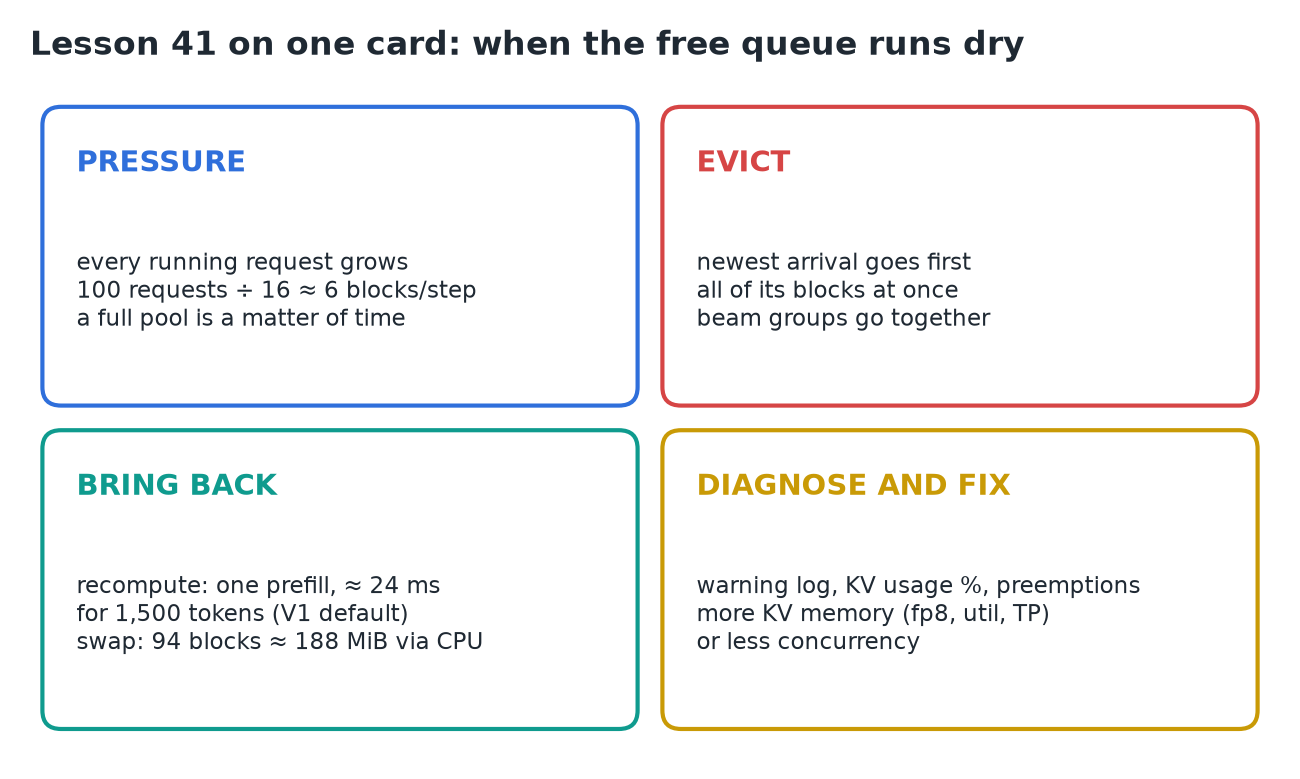
Block phân trang làm bộ nhớ KV hiệu quả, nhưng nó vẫn hữu hạn. Mọi request đang chạy đều lớn dần, nên dưới tải, free queue sớm muộn sẽ cạn trong khi chưa ai xong. Khi đó vLLM đuổi request đến gần nhất, toàn bộ block của nó một lúc, và sau đó đưa nó trở lại bằng cách tính lại các token của nó trong một lượt prefill (mặc định của V1, ≈ 24 ms cho 1.500 token trên Llama 3.1 8B) hoặc bằng cách swap block của nó qua bộ nhớ CPU. Preemption thường xuyên nghĩa là có áp lực KV: theo dõi log cảnh báo cùng các metric mức dùng KV và preemption, rồi cho cache thêm bộ nhớ hoặc yêu cầu ít việc cùng lúc hơn.
1. Áp lực tích tụ âm thầm
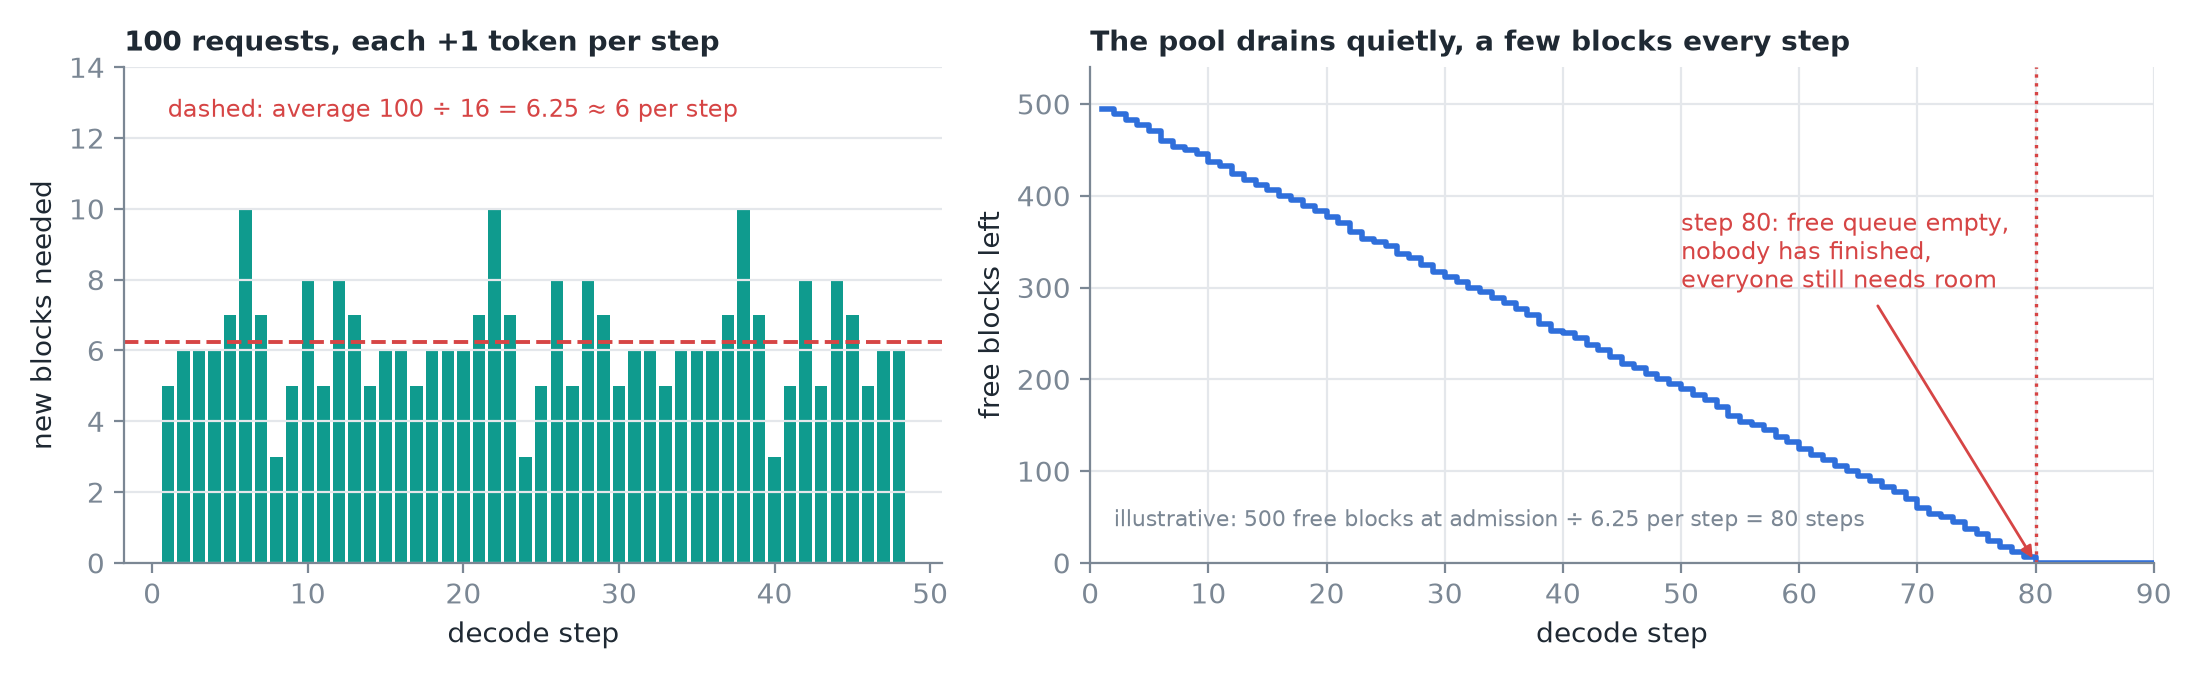 Trái: khi các request ở những điểm khác nhau trong block của chúng, nhu cầu block mới dao động quanh 6,25 mỗi bước. Phải: pool cạn dần với tốc độ đó cho tới khi một bước xin block mà không còn cái nào.
- Mỗi request đang chạy thêm một token mỗi bước; với block 16 token, mỗi request cần block mới khoảng mỗi 16 bước một lần.
- Với 100 request đang decode: 100 ÷ 16 ≈ 6 block mới mỗi bước.
- Scheduler nhận mỗi request dựa trên chỗ nó cần tại thời điểm đó; nó không thể biết mỗi câu trả lời sẽ dài tới đâu.
- Khoảnh khắc đáng sợ nhất: free queue trống, chưa ai xong nên không có gì sắp được giải phóng, và ai cũng cần chỗ cho token tiếp theo.
2. Đẩy ai đó ra
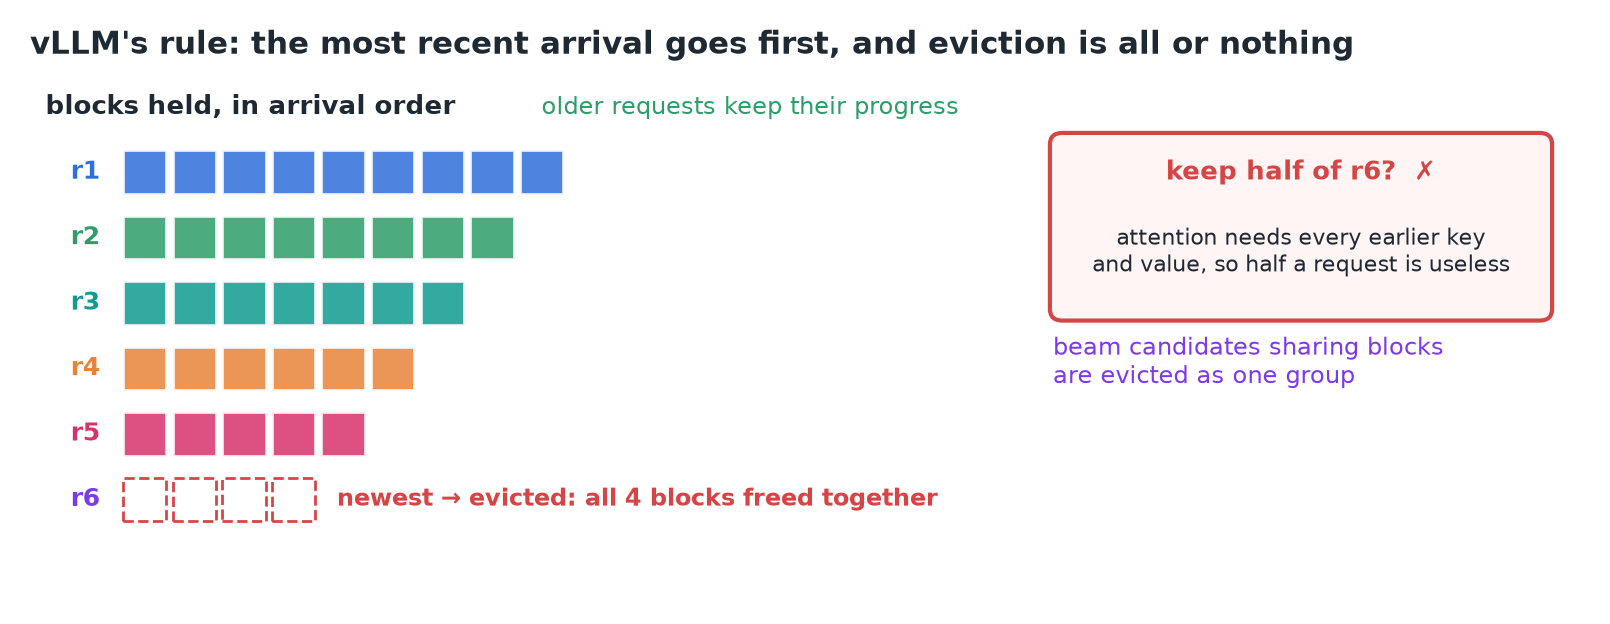 Request mới nhất bị đuổi nguyên khối; các request cũ hơn giữ được tiến độ.
- Quy tắc của vLLM theo thứ tự đến: request đến gần đây nhất bị đuổi trước, để các request cũ hơn giữ được tiến độ.
- Đuổi là tất cả hoặc không gì cả. Attention cần mọi key và value trước đó, nên giữ lại một nửa số block của request là vô dụng.
- Các ứng viên beam dùng chung block bị đuổi cùng nhau thành nhóm.
3. Đưa nạn nhân trở lại: tính lại hay swap
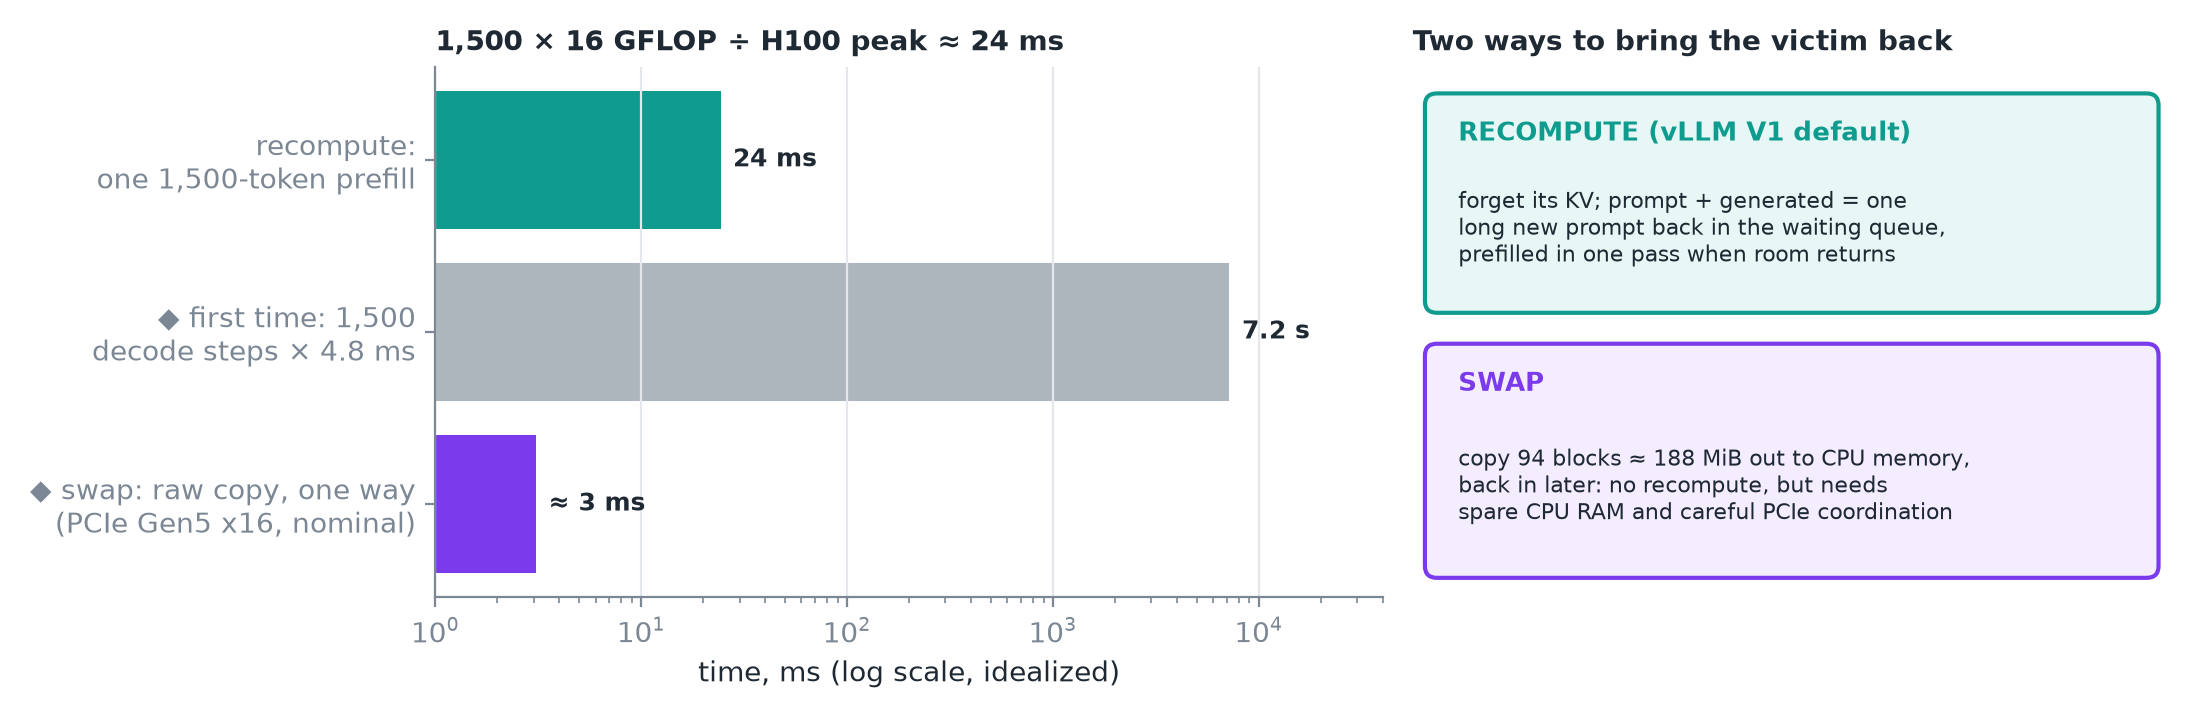 Tính lại làm lại KV trong một lượt song song; swap gửi nó vào bộ nhớ CPU. ◆ Các thanh xám và tím là ước lượng của tôi.
Tính lại (recompute) quên KV của nạn nhân. Nó quay về hàng đợi waiting với prompt + mọi thứ đã sinh tới giờ được coi như một prompt mới dài, được prefill trong một lượt song song khi có chỗ; sau đó decode tiếp tục từ chỗ đã dừng.
- Đó là Llama 3.1 8B ở mức đỉnh của H100 (lý tưởng hoá), nhanh hơn rất nhiều so với lần đầu sinh từng token một. ◆ Ở mức lý tưởng hoá 4,8 ms mỗi bước decode, 1.500 bước mất khoảng 7,2 s.
Swap chép các block của nạn nhân ra bộ nhớ CPU và chép ngược lại sau:
- Nó tránh phải tính lại, nhưng cần bộ nhớ CPU dư và điều phối cẩn thận trong lúc dữ liệu di chuyển qua PCIe.
- Engine hiện tại của vLLM (V1) mặc định dùng tính lại.
Mẹo
◆ Bản thân việc chép không phải nút thắt: 188 MiB qua PCIe Gen5 x16 (~64 GB/s danh định) mất khoảng 3 ms mỗi chiều. Cái giá thực sự của swap là bộ nhớ CPU dư và việc điều phối.
4. Thrashing
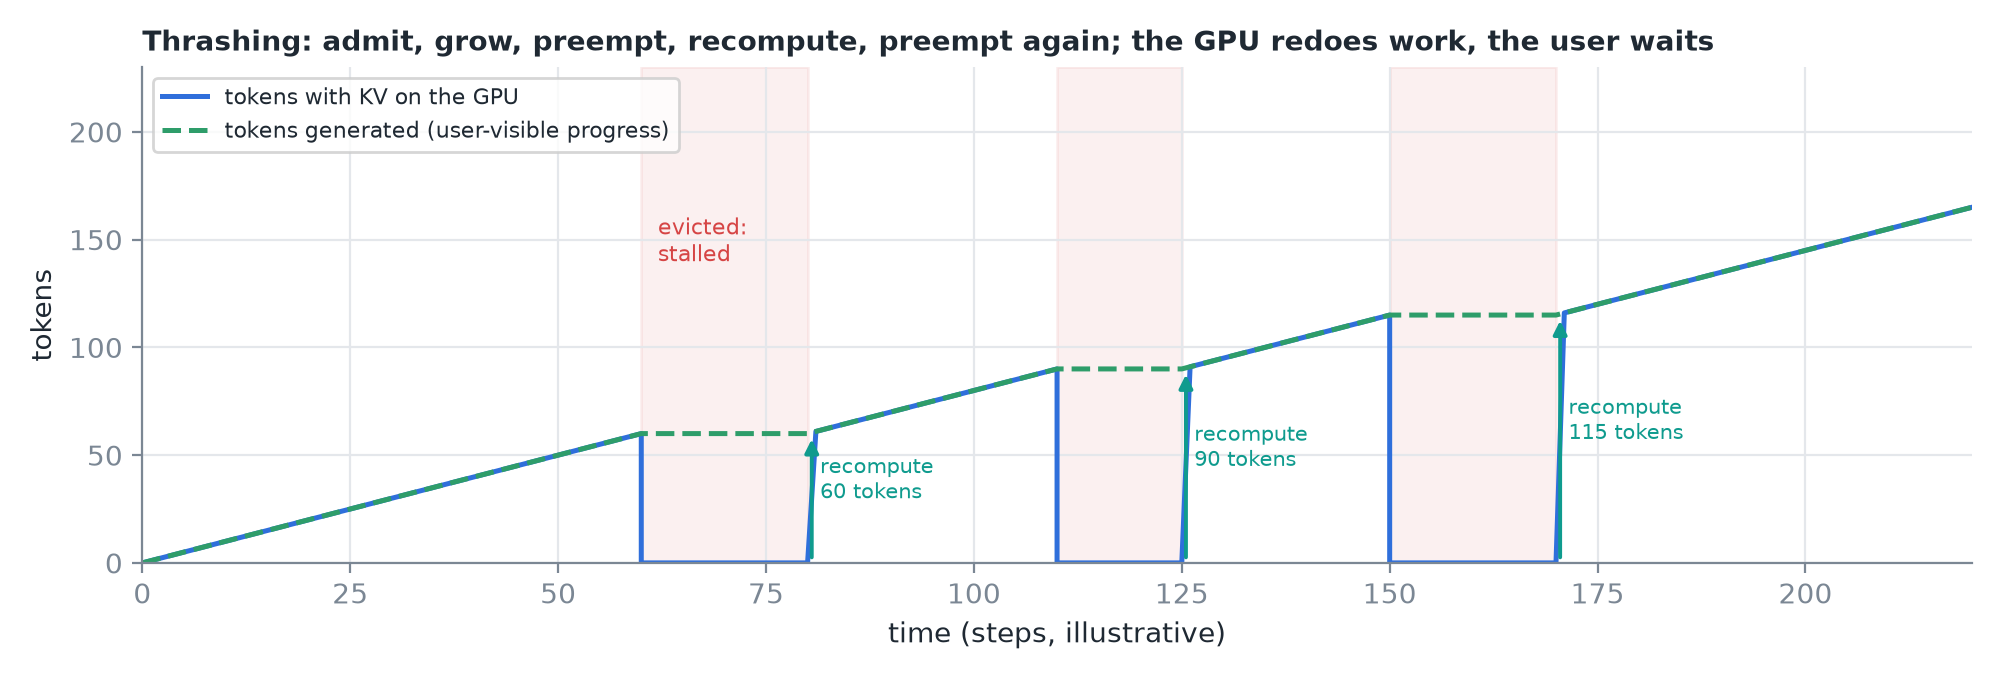 Một request mắc kẹt trong vòng lặp (thời gian minh hoạ): mỗi lần bị đuổi nó khựng lại, và mỗi lần quay lại nó phải prefill lại mọi thứ đã có.
- Một lần preemption thì không sao; một dòng liên tục là vấn đề. Engine nhận một request, mọi người lớn dần, ai đó bị preempt, được tính lại, rồi lại bị preempt.
- Đó là thrashing: thời gian GPU dồn vào làm lại việc cũ, và người dùng thấy câu trả lời khựng lại.
5. Phát hiện và sửa
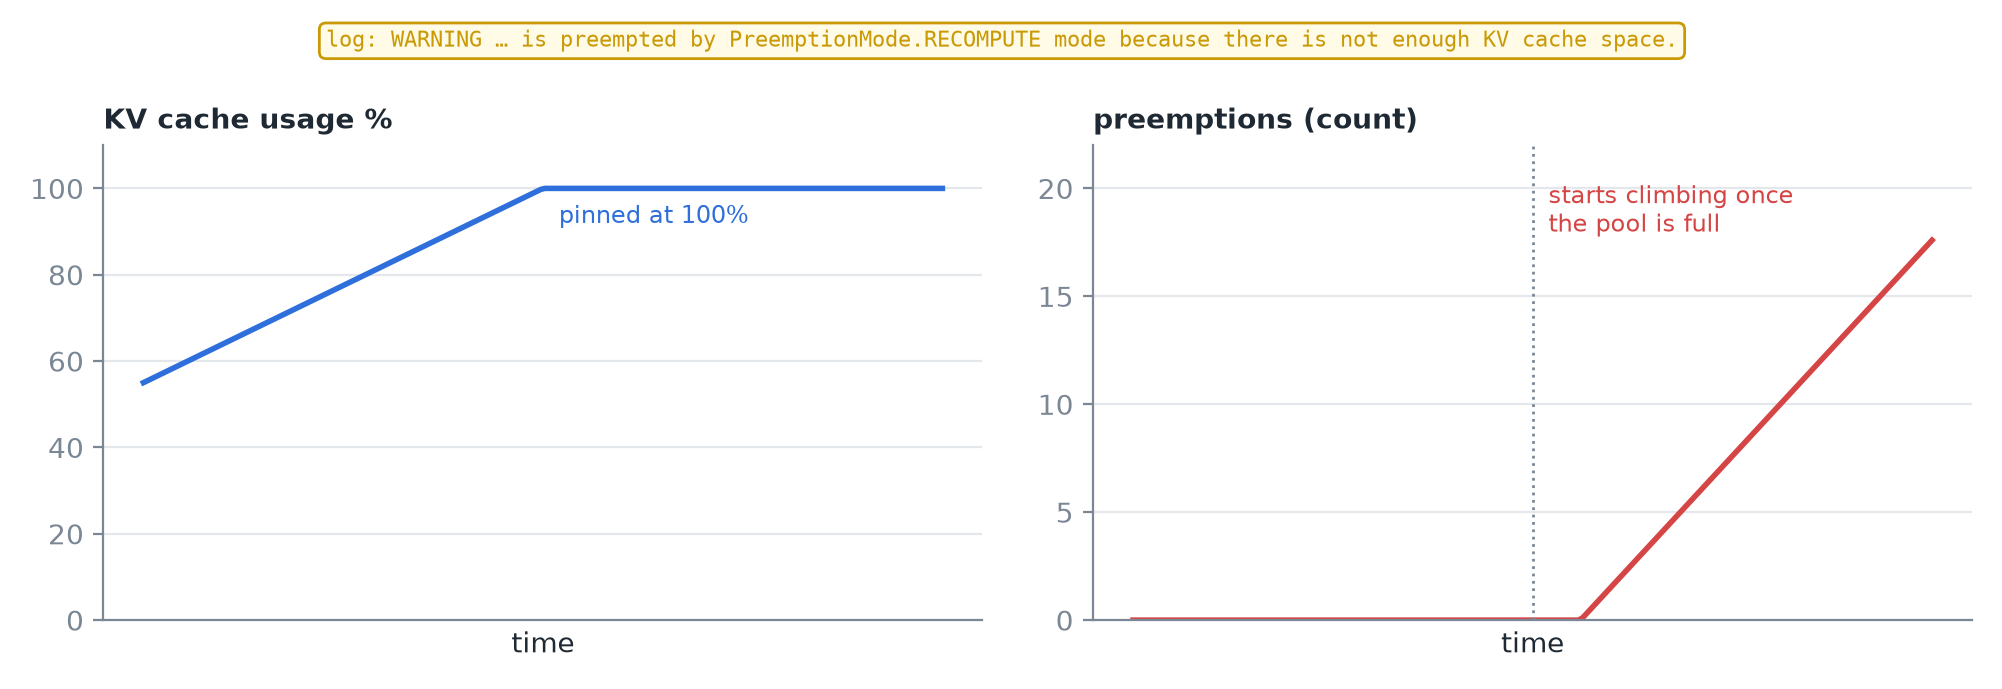 vLLM ghi một cảnh báo cho mỗi lần preemption và xuất metric cho mức dùng KV cache và số lần preemption; preemption tăng vọt khi mức dùng ghim ở 100%.
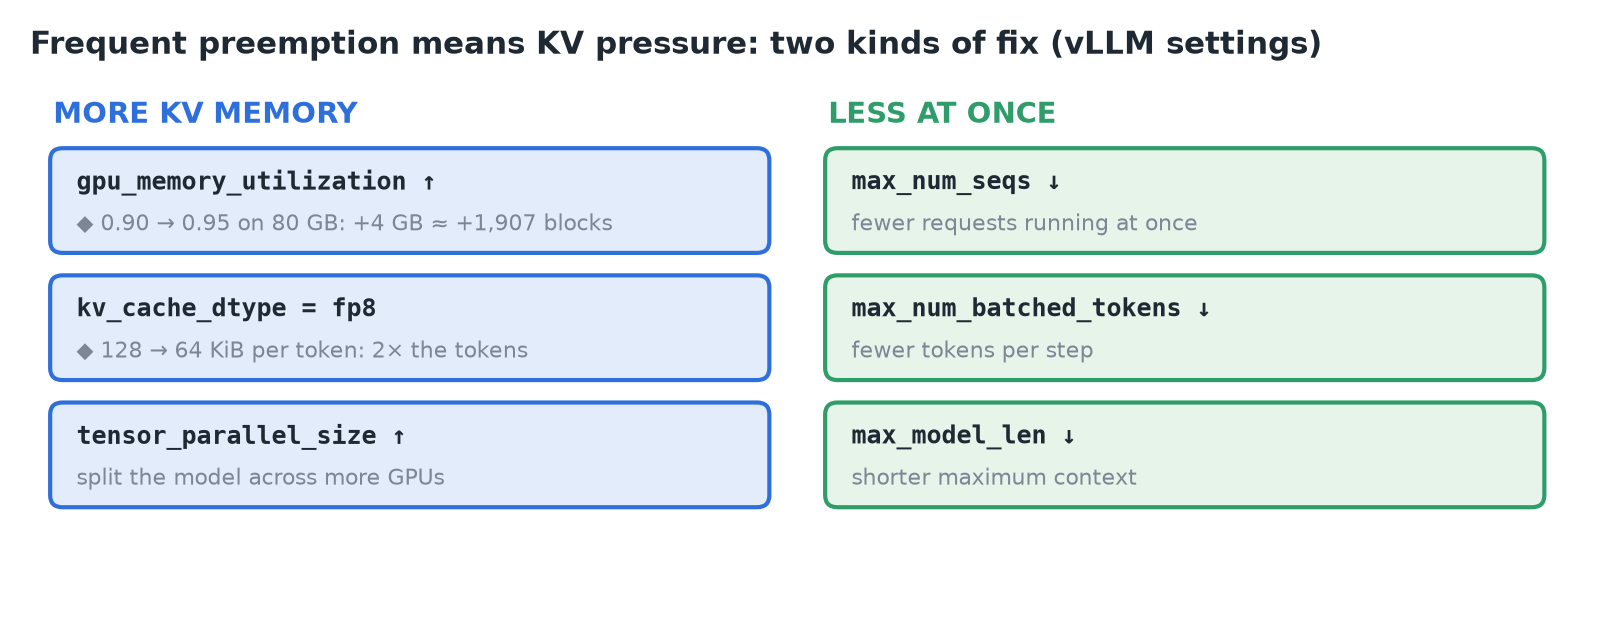 Hai nhóm cách sửa. ◆ Hai ước lượng giả định GPU 80 GB và 128 KiB mỗi token của Llama 3.1 8B.
Quan trọng
Preemption thường xuyên là vấn đề định cỡ: hoặc cho KV cache thêm bộ nhớ, hoặc yêu cầu ít concurrency hơn.
6. Tóm tắt