28 · Vì sao serving bằng PyTorch thuần sụp đổ
Nguồn: fanout.sh / inference-eng / 06-01 · ~6 phút
Ghi chú
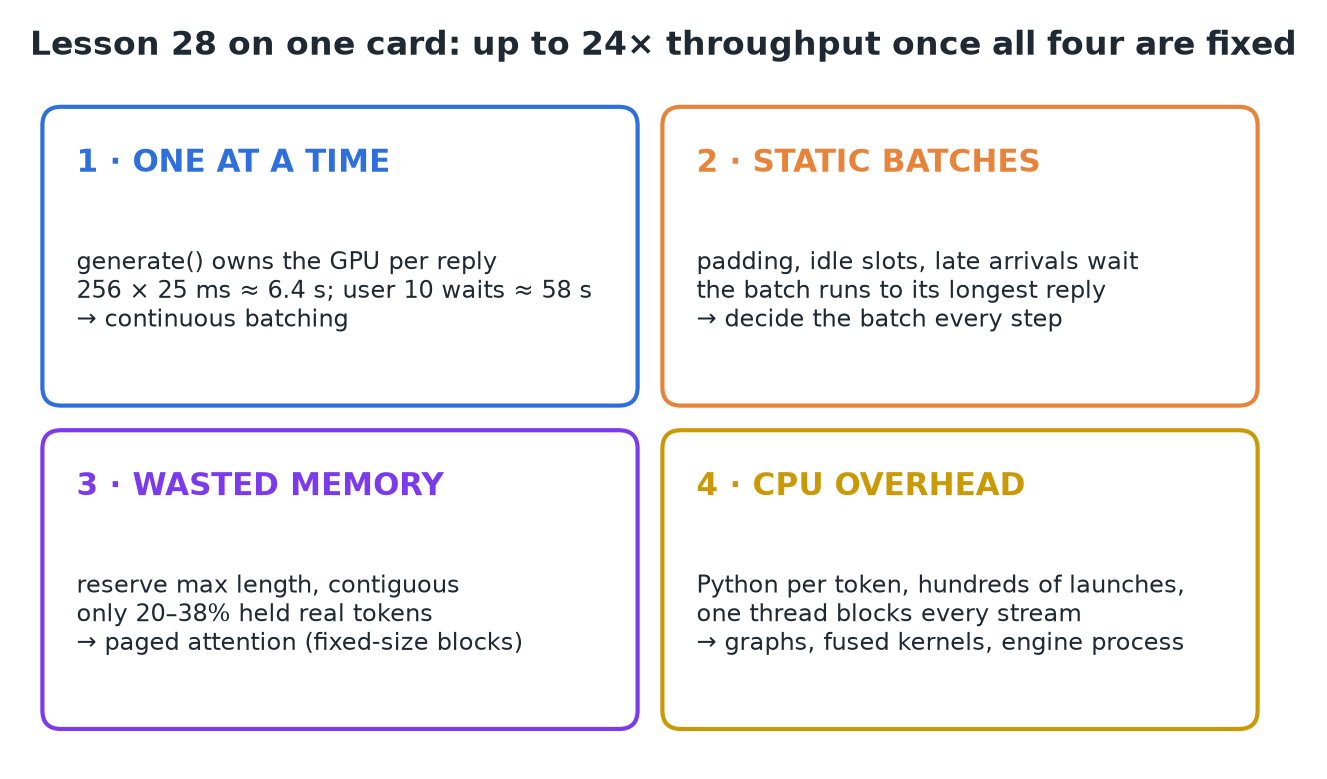
Một server mười dòng gọi model.generate() chạy ổn với một người dùng và sụp đổ ở năm mươi người, vì bốn lý do. Request chạy từng cái một, nên cả latency lẫn throughput đều tệ hại. Batch tĩnh phải padding, để slot ngồi không và bắt request đến muộn phải chờ. Đặt trước vùng KV liền mạch với độ dài tối đa lãng phí phần lớn bộ nhớ (chỉ 20–38% thực sự chứa token trong các hệ thống trước đây). Overhead Python cho mỗi token ăn vào mọi bước. Một inference engine thay mỗi thứ bằng một ý tưởng tốt hơn (continuous batching, lập lịch theo từng bước, block phân trang, graph và một process engine riêng), đáng giá throughput cao tới 24 lần so với Hugging Face Transformers thuần.
1. Server LLM đơn giản nhất có thể
from fastapi import FastAPI
from transformers import AutoModelForCausalLM, AutoTokenizer

app = FastAPI()
tok = AutoTokenizer.from_pretrained(MODEL)
model = AutoModelForCausalLM.from_pretrained(MODEL, device_map="cuda")

@app.post("/generate")
def generate(prompt: str) -> str:
    ids = tok(prompt, return_tensors="pt").to("cuda")
    out = model.generate(**ids, max_new_tokens=256)
    return tok.decode(out[0], skip_special_tokens=True)
Mười dòng. Với một người dùng nó chạy hoàn hảo; với năm mươi người thì sụp đổ.
2. Vấn đề 1: request chạy từng cái một
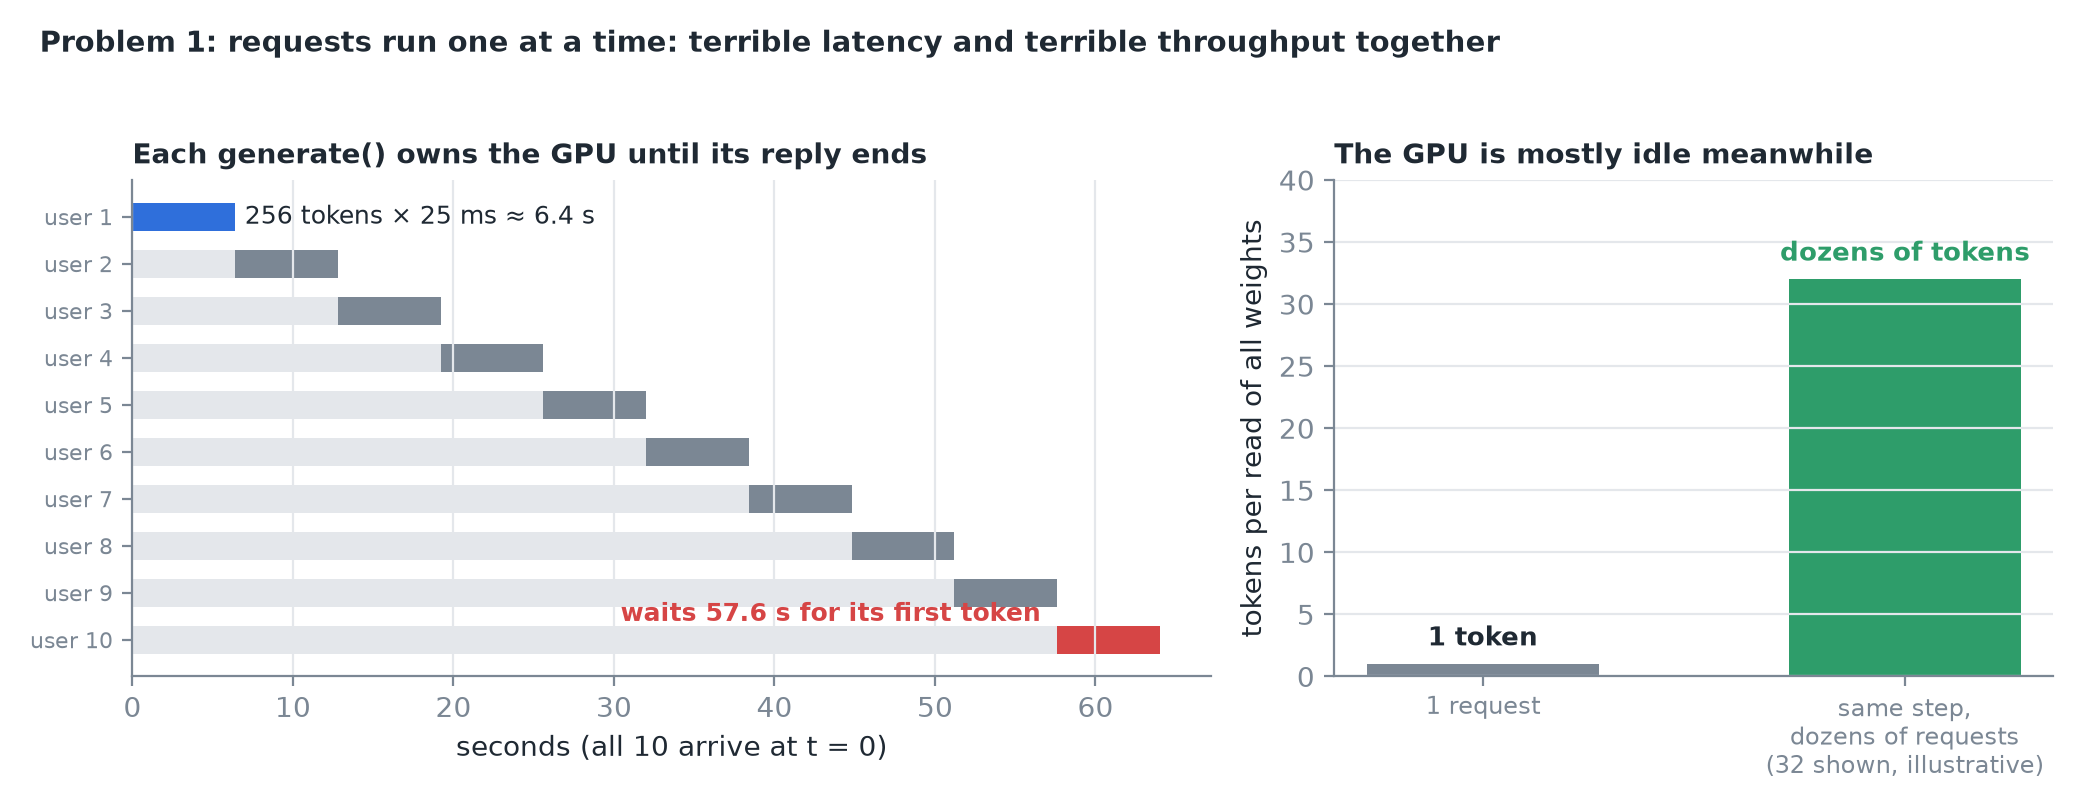 Mỗi lần gọi generate chiếm GPU cho tới khi câu trả lời xong, và mỗi bước decode đọc toàn bộ trọng số chỉ để làm ra một token.
- Người dùng thứ hai chờ 6,4 s mới thấy token đầu tiên; người thứ mười chờ gần một phút.
- Trong khi đó GPU gần như rảnh: cùng bước đó lẽ ra phục vụ được hàng chục request với chi phí gần như không đổi.
- Vì vậy server ngây thơ cho ra latency tệ hại và throughput tệ hại cùng một lúc.
3. Vấn đề 2: batch tĩnh
Cách sửa hiển nhiên là batching: gom vài request và chạy chúng cùng nhau. Nhưng batching thông thường là tĩnh: batch được lập một lần và chạy cho tới khi mọi request trong đó xong.
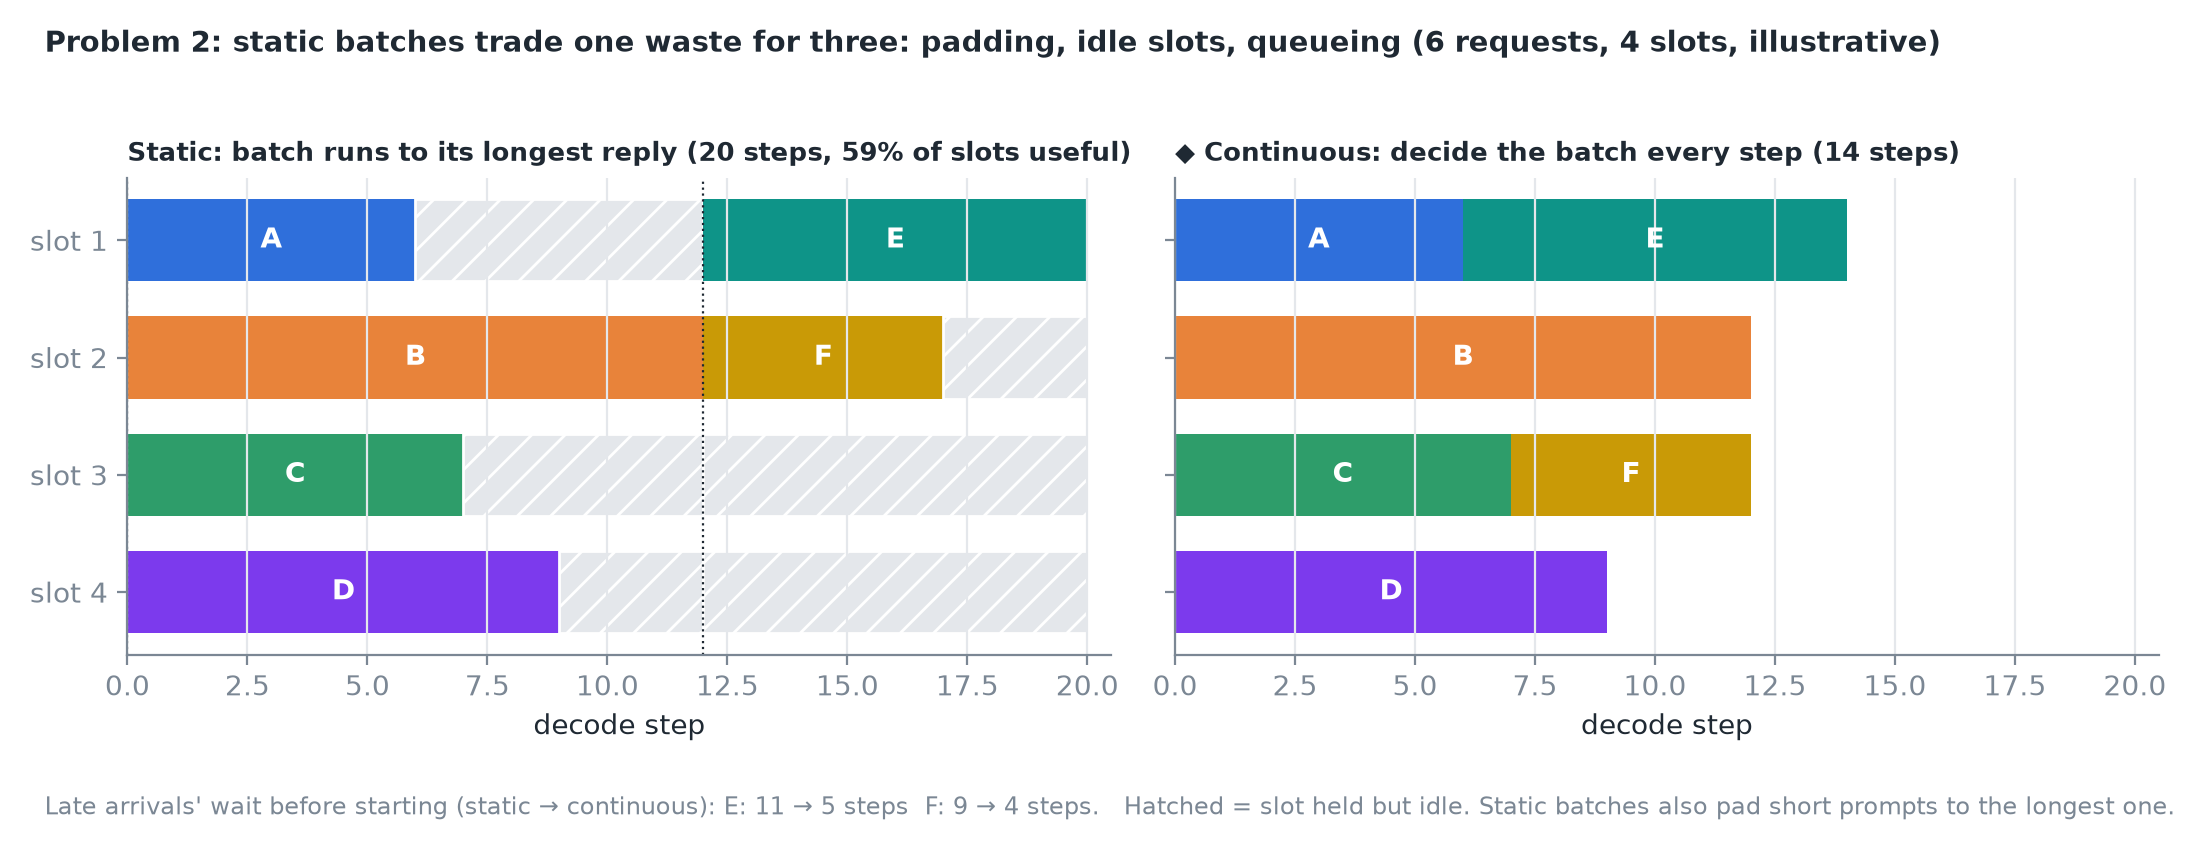 ◆ Cùng sáu request trên bốn slot: batch tĩnh giữ các slot đã xong ngồi không cho tới khi câu trả lời dài nhất kết thúc, và request E, F phải chờ cả batch.
| Lãng phí | Vì sao |
|---|---|
| Padding | Prompt dài ngắn khác nhau, nên cái ngắn được đệm cho bằng cái dài nhất; phần đệm đó được tính rồi vứt đi |
| Slot ngồi không | Request xong sớm vẫn giữ slot, không làm gì, cho tới khi câu trả lời dài nhất kết thúc |
| Xếp hàng | Request đến một giây sau khi batch bắt đầu phải chờ cả batch |
Quan trọng
Engine quyết định batch ở mọi bước: request đã xong rời đi ngay và request mới vào ở bước tiếp theo. Đó là continuous batching.
4. Vấn đề 3: lãng phí bộ nhớ
Một cài đặt thông thường lưu KV cache của mỗi request thành một tensor liền mạch, và vì chưa biết độ dài cuối cùng, nó đặt trước chỗ cho độ dài tối đa ngay từ đầu.
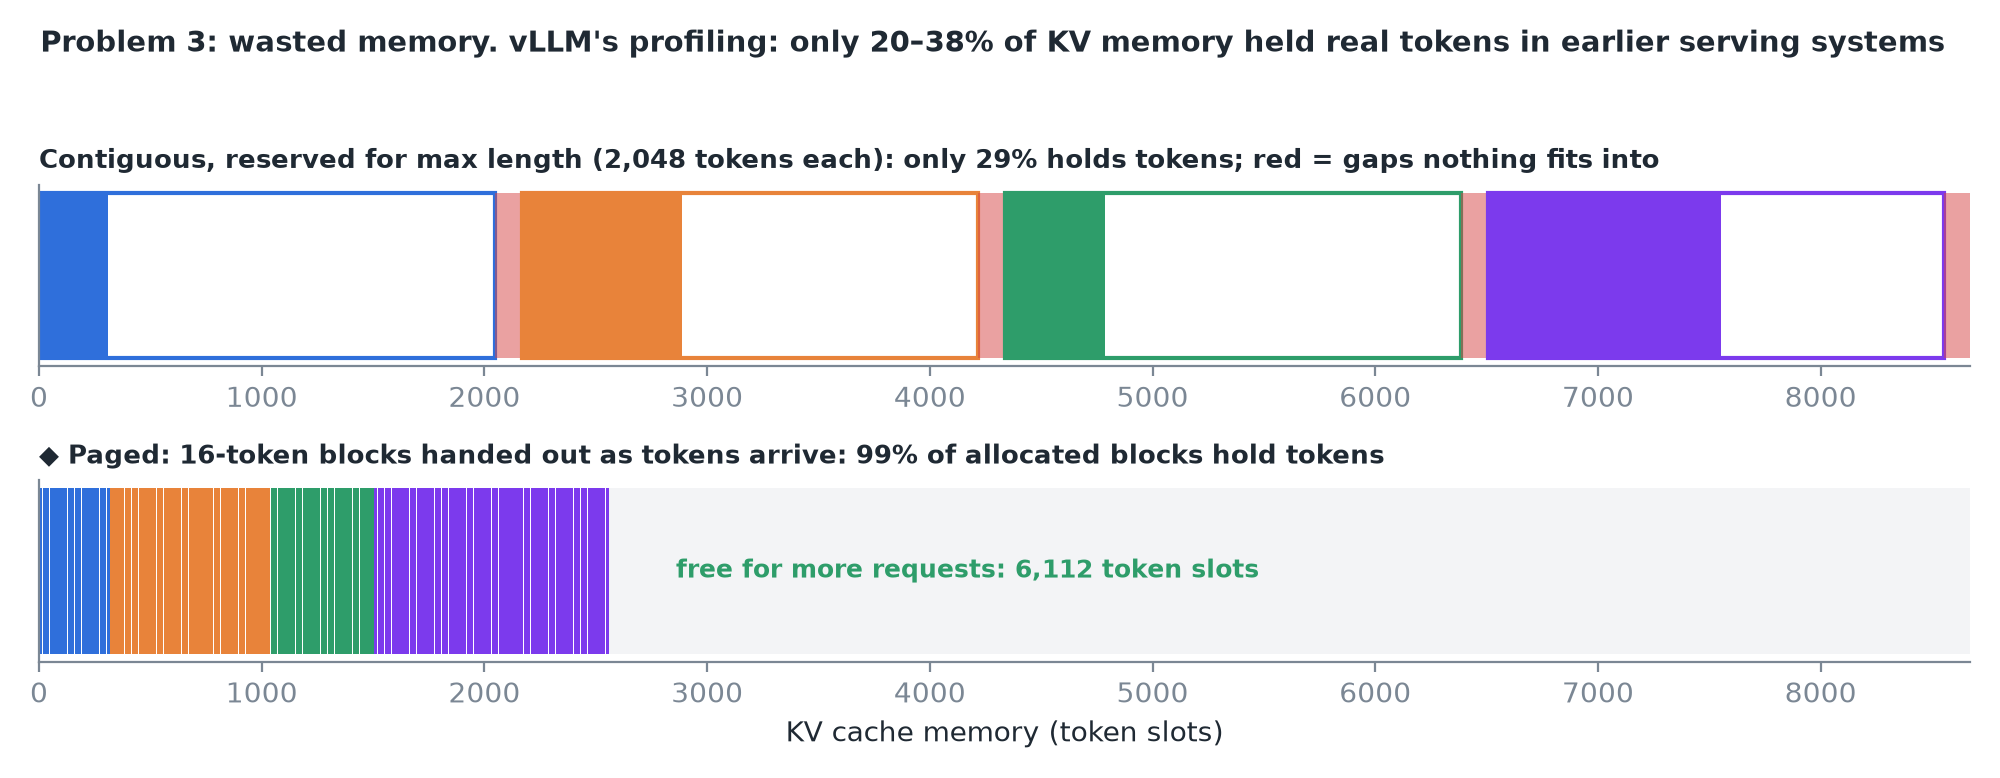 Phần lớn câu trả lời kết thúc rất lâu trước mức tối đa, nên phần lớn chỗ đặt trước không bao giờ được dùng, và các vùng đặt trước kích thước khác nhau để lại những khe hở không gì lấp vào được. ◆ Block phân trang chỉ lãng phí tối đa một phần của một block mỗi request.
- Khi team vLLM profile các hệ thống serving trước đây, chỉ 20–38% bộ nhớ KV cache chứa dữ liệu token (paper vLLM, SOSP 2023).
- Cache lãng phí → ít request vừa hơn → batch nhỏ hơn → throughput thấp hơn.
- Engine lưu cache trong các block nhỏ kích thước cố định, chỉ cấp ra khi token đến. Đó là paged attention.
5. Vấn đề 4: overhead CPU
Một bước decode trên GPU có thể chỉ mất vài mili giây. Trong một vòng lặp Python thông thường, mỗi bước còn chạy sampling, kiểm tra điều kiện dừng và detokenize bằng Python, và launch hàng trăm kernel GPU nhỏ từng cái một.
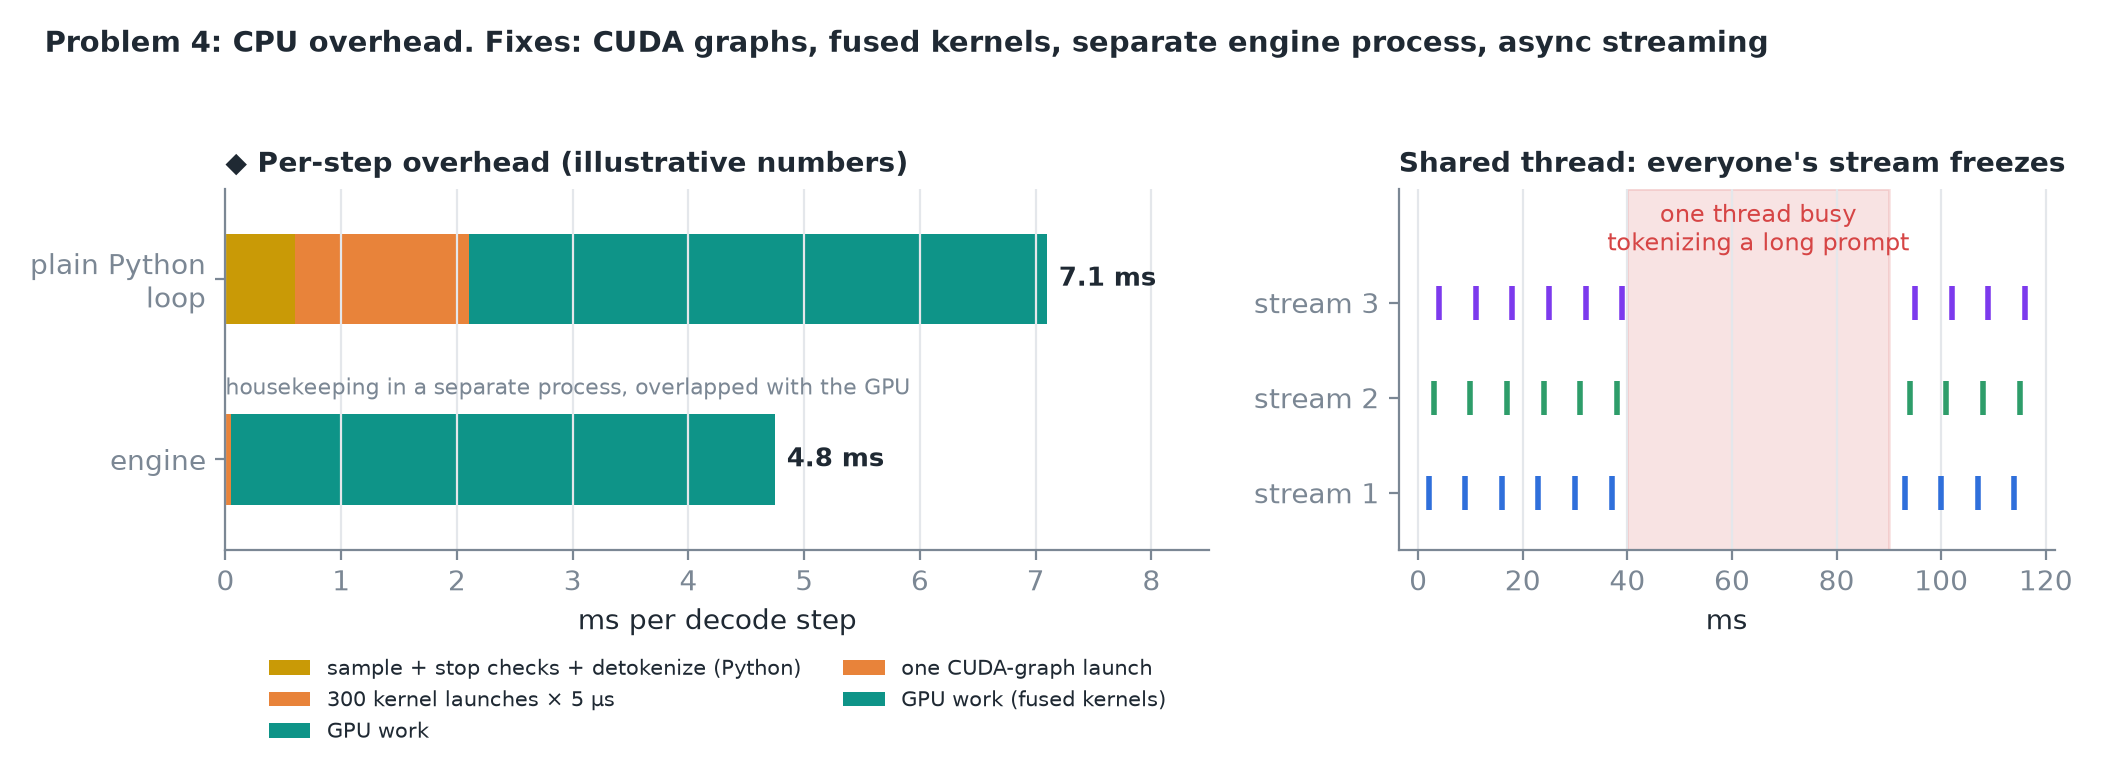 Mỗi lần launch tốn vài micro giây thời gian CPU; qua hàng trăm kernel, nó thành một phần thật sự của mỗi bước. Nếu tokenize, xử lý HTTP và sinh token dùng chung một thread, tokenize một prompt dài sẽ chặn luồng stream của mọi người.
Engine tấn công nó từ nhiều phía:
- CUDA graph: capture cả một bước và phát lại bằng một lần launch.
- Fused kernel: ít kernel hơn, kernel lớn hơn.
- Một process engine riêng: scheduler và công việc GPU chạy tách khỏi HTTP và tokenize.
- Streaming bất đồng bộ: token được gửi đi mà không chặn vòng lặp.
6. Engine thay đổi những gì
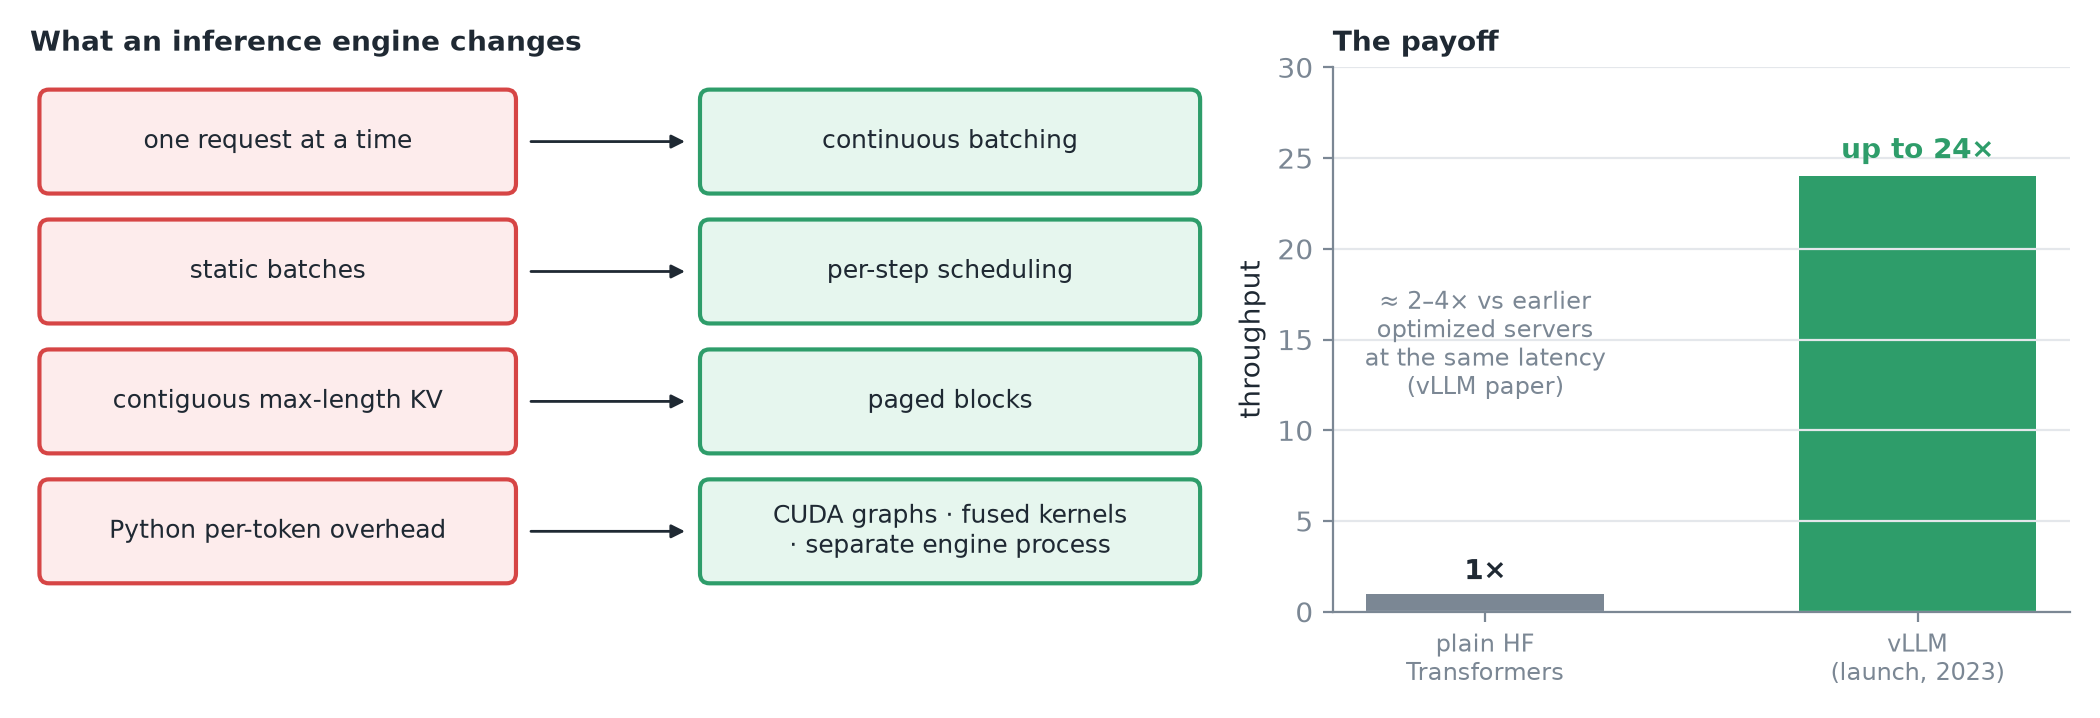 Khi vLLM ra mắt (2023), tác giả báo throughput cao tới 24 lần so với serving bằng Hugging Face Transformers thuần, và khoảng 2–4 lần so với các server đã tối ưu trước đó ở cùng latency.
7. Tóm tắt