47 · Automatic prefix caching
Nguồn: fanout.sh / inference-eng / 10-05 · ~5 phút
Ghi chú
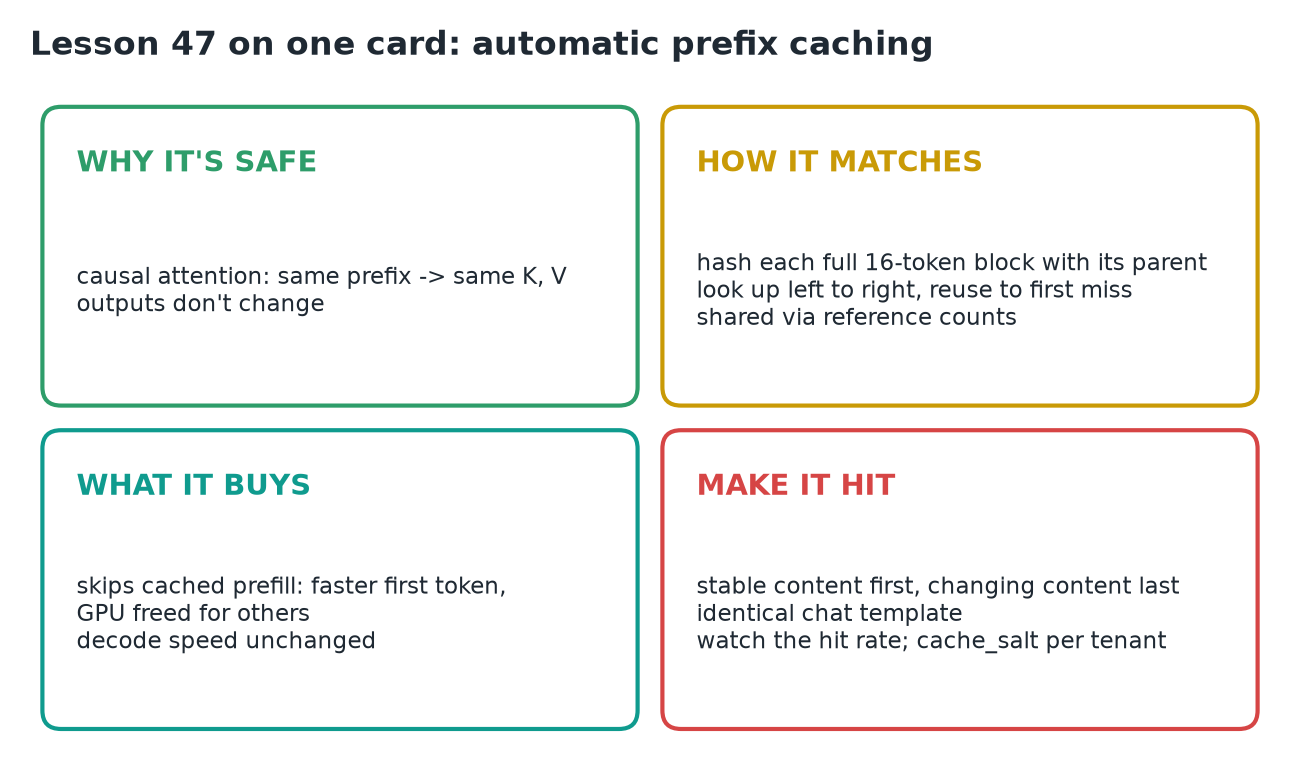
Causal attention có nghĩa là một prefix giống hệt sinh ra KV cache giống hệt, nên một request có thể mượn K và V của request khác cho phần đầu chung và chỉ tính phần mới, mà đầu ra không đổi. vLLM tìm phần khớp bằng cách hash từng block 16 token đầy đủ cùng với hash của block cha và dùng lại block cho tới lần trượt đầu tiên. Cache hit bỏ qua prefill: trong benchmark của vLLM, TTFT trung bình giảm 108 → 68 ms ở 80% hit, nhưng tốc độ decode không đổi. Việc so khớp là chính xác tính từ token một, nên hãy đặt nội dung ổn định lên trước, nội dung thay đổi xuống cuối, và theo dõi hit rate.
1. Cùng một phần việc, ở mọi request
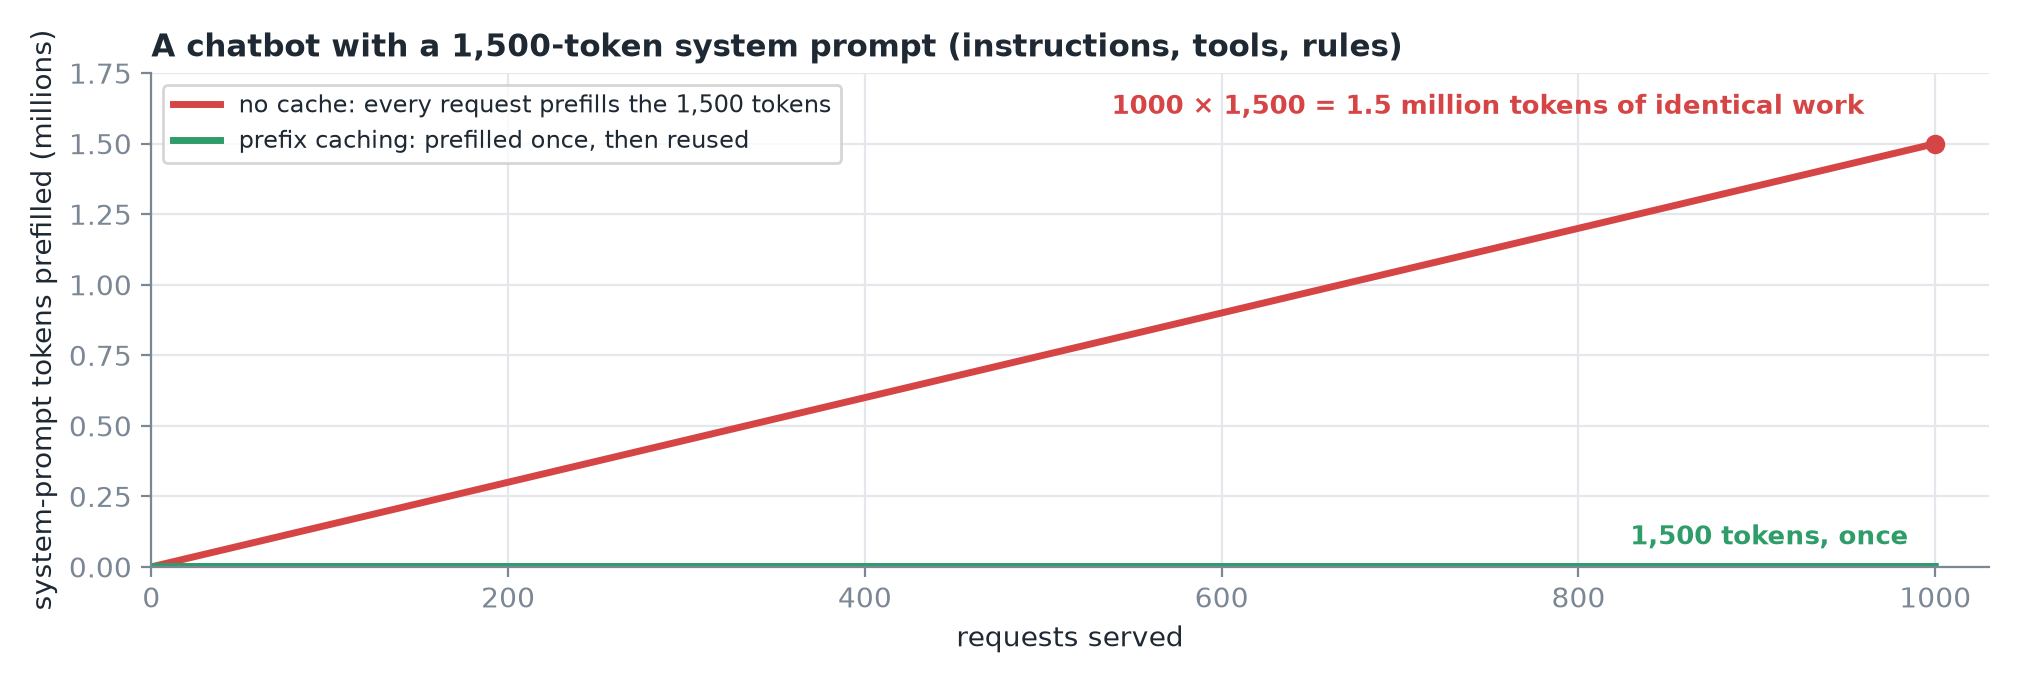 Không có cache, system prompt dùng chung được prefill lại từ đầu ở mọi request.
- System prompt 1.500 token của một chatbot (hướng dẫn, tool, quy tắc) mở đầu mọi request.
- Automatic prefix caching làm phần việc đó một lần rồi dùng lại.
2. Vì sao dùng lại an toàn: causal attention
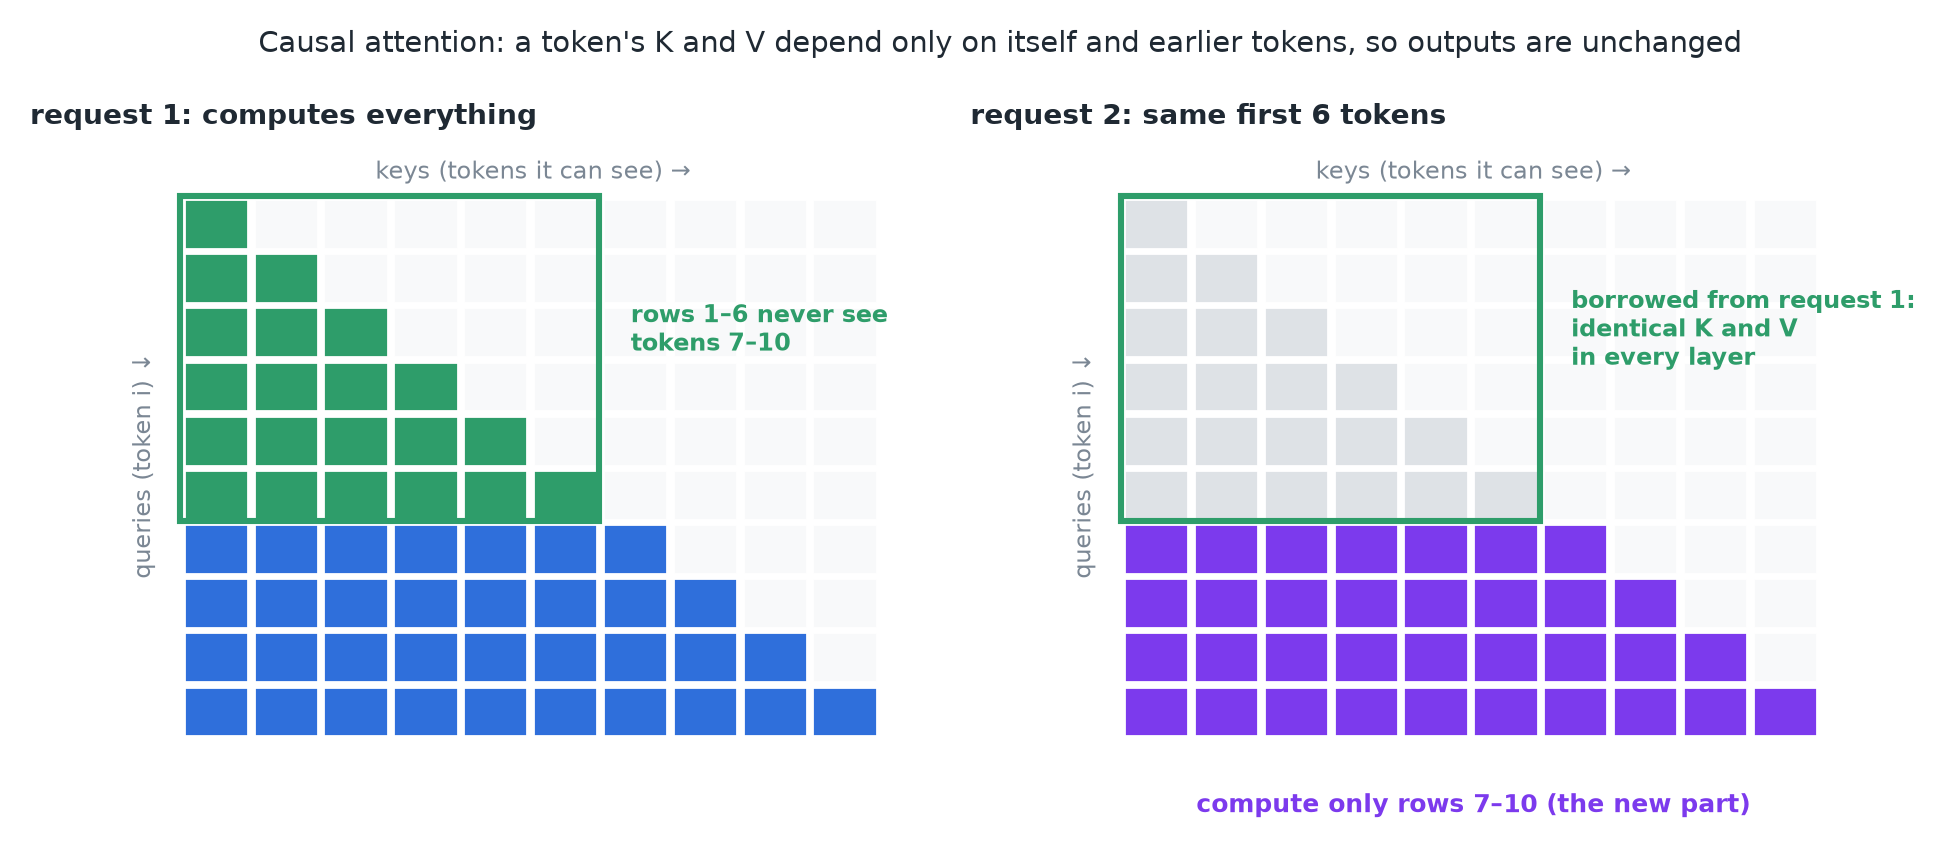 Hàng là token query, cột là các token mỗi query được attend; các hàng của prefix chung không bao giờ thấy phần đuôi.
- Key và value của một token chỉ phụ thuộc vào chính token đó và các token trước nó, không bao giờ phụ thuộc vào những gì đến sau.
- Hai prompt có cùng phần đầu chính xác vì thế có K và V giống hệt cho phần đầu đó, ở mọi layer.
- Request 2 mượn cache của request 1 cho phần chung và chỉ tính phần mới. Đầu ra của model không thay đổi chút nào.
3. Tìm prefix chung thật nhanh
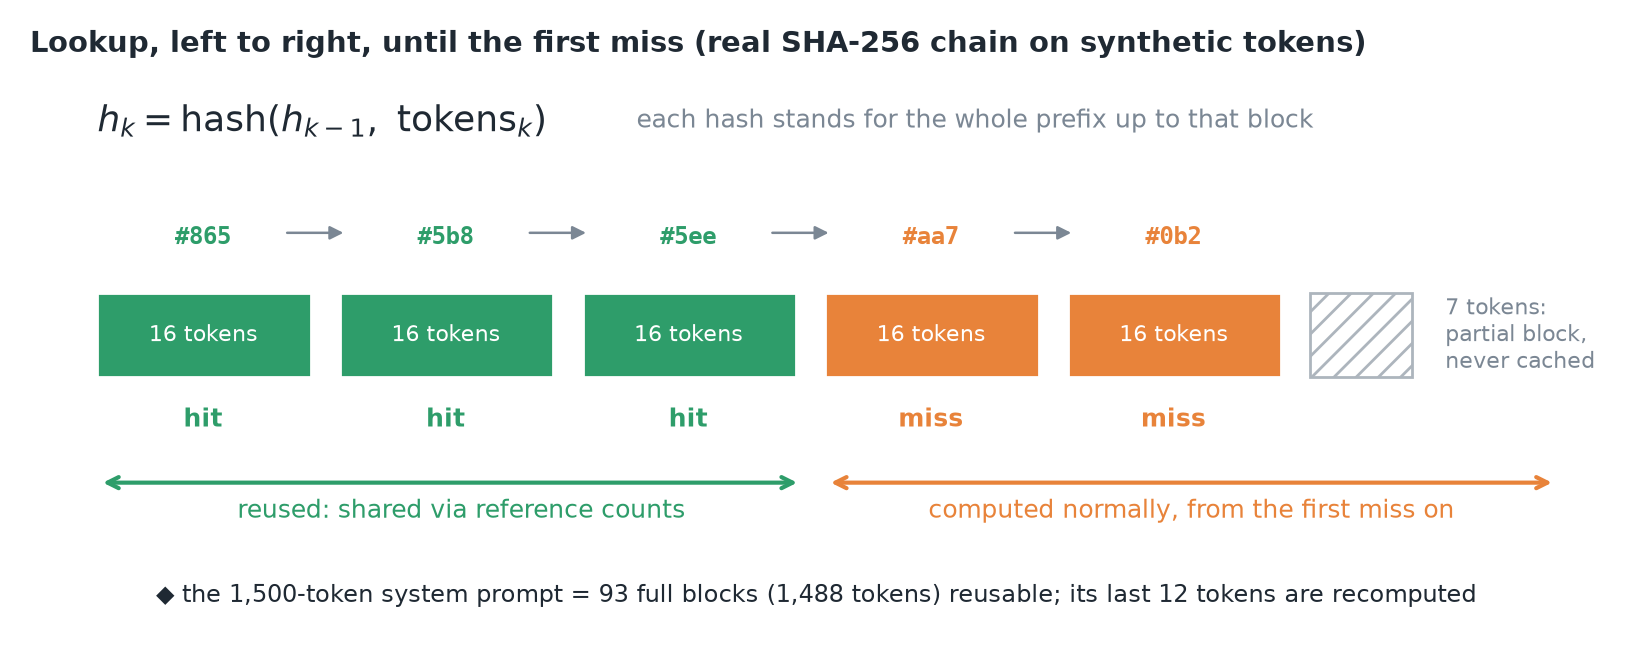 Chuỗi hash trên các block 16 token; việc dùng lại dừng ở lần trượt đầu tiên.
- vLLM làm việc theo từng KV block, mỗi block 16 token, và lấy dấu vân tay mọi block đầy đủ:
- Vì mỗi hash bao gồm hash của block cha, một hash đại diện cho toàn bộ prefix tới block đó, không chỉ 16 token của nó.
- Khi request đến, engine hash prompt theo từng block và tra từng hash từ trái sang phải: trúng, trúng, trúng, trượt lần đầu. Mọi thứ trước lần trượt được dùng lại; mọi thứ từ lần trượt trở đi được tính bình thường.
- Chỉ block đầy đủ được cache, nên việc dùng lại đi theo bậc 16 token; block cuối chưa đầy không bao giờ được cache.
- Block khớp được chia sẻ qua reference count, cùng cơ chế chia sẻ với block copy-on-write.
4. Được gì, và không được gì
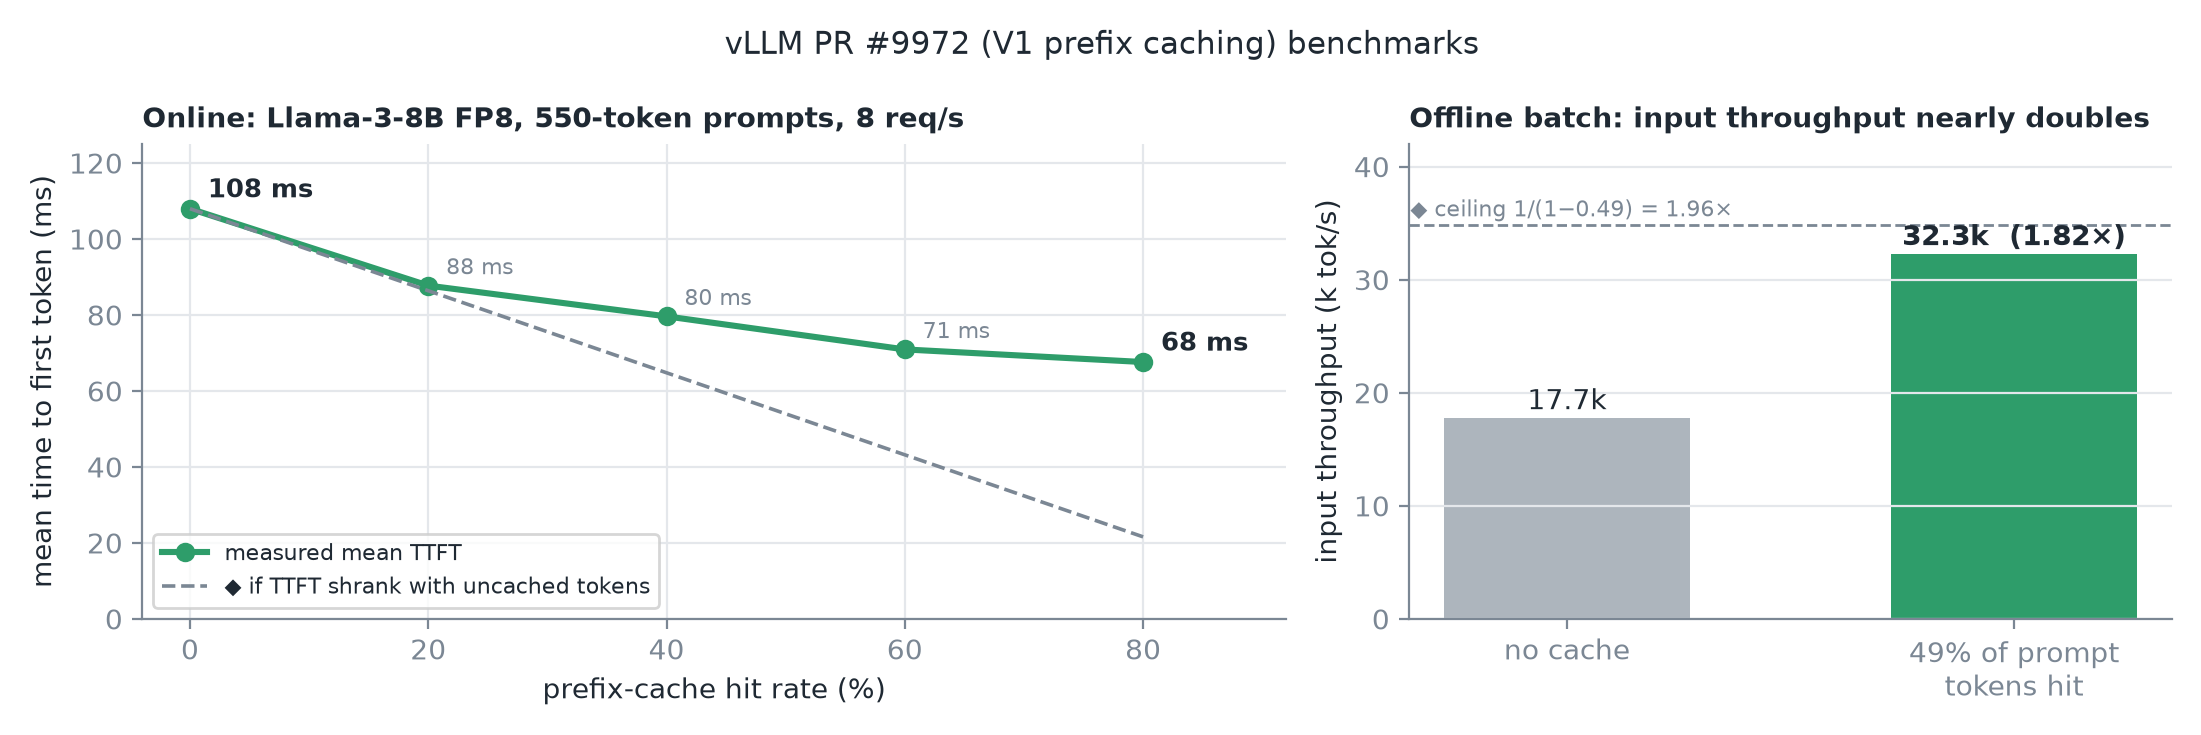 PR #9972 của vLLM: bài học trích các điểm 0% và 80%; ◆ các điểm ở giữa và đường nét đứt lấy từ cùng bảng trong PR hoặc từ phép tính của tôi.
- Prefill cho phần đã cache được bỏ qua: token đầu tiên đến sớm hơn và GPU có thêm thời gian cho mọi người khác.
- Online (Llama-3-8B FP8, prompt 550 token, 8 req/s): TTFT trung bình ≈ 108 ms ở 0% hit → ≈ 68 ms ở 80% hit.
- Offline, với khoảng một nửa số token prompt trúng cache: throughput đầu vào gần gấp đôi (17,7 nghìn → 32,3 nghìn tok/s, 1,82 lần).
Mẹo
◆ TTFT giảm 37%, không phải 80%. Một phần thời gian tới token đầu tiên không co lại khi ít token prompt hơn: lập lịch, phần đuôi chưa cache, và lấy mẫu token đầu tiên. Lợi ích offline nằm gần trần 1/(1 − 0,49) ≈ 1,96 lần của nó, vì một batch job gần như toàn là prefill. Cùng PR đó cũng cho thấy time per output token trung bình giảm từ 29 xuống 25 ms ở 80% hit. Bản thân decode không nhanh hơn; chỉ là có ít prefill tranh tài nguyên với nó hơn.
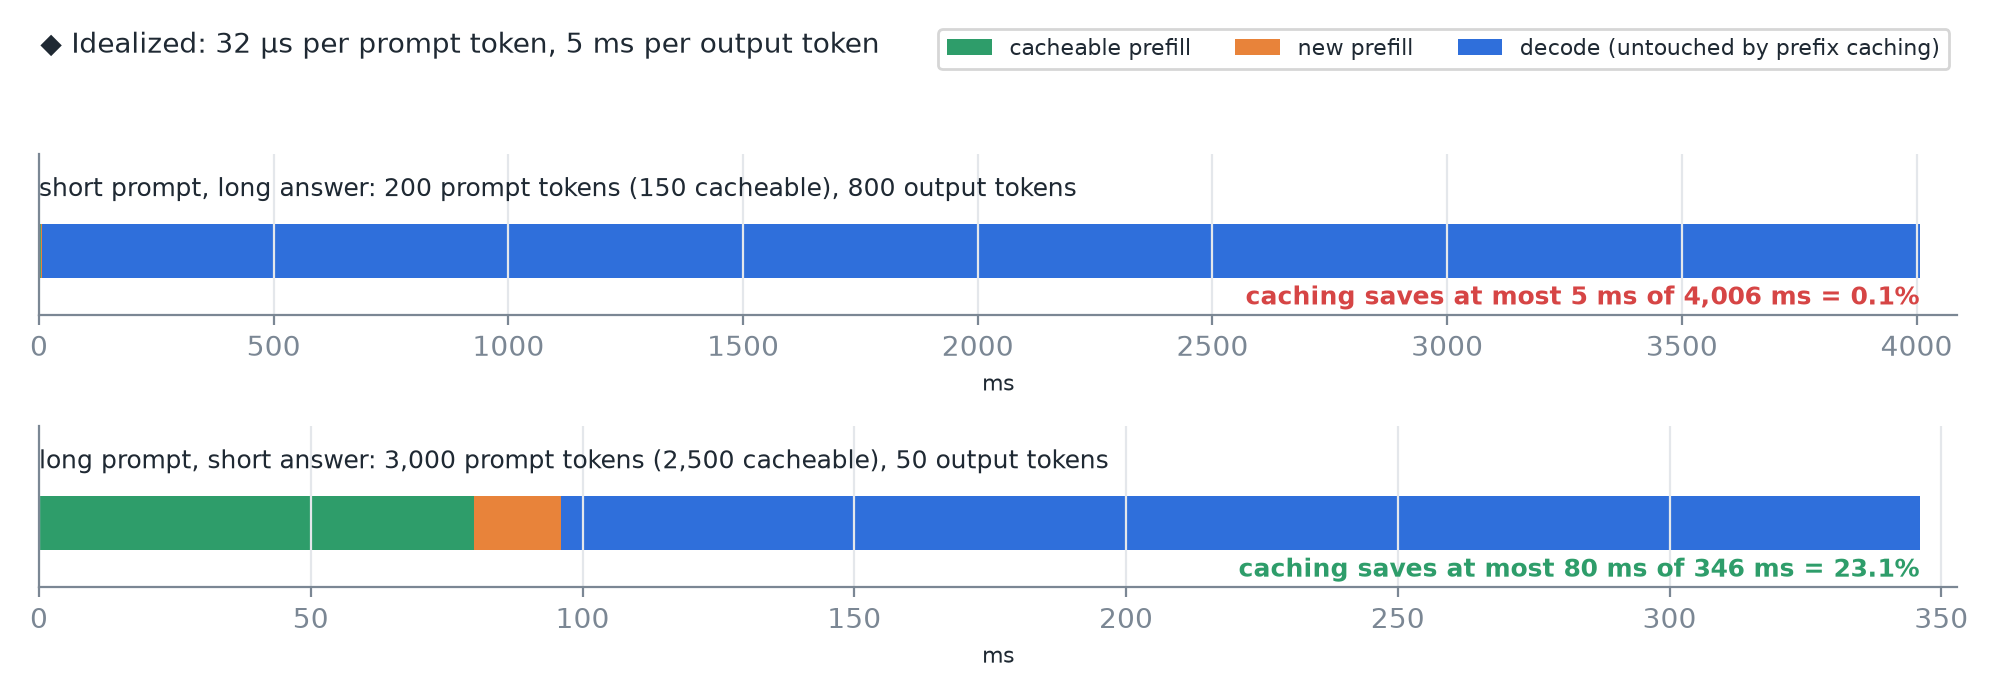 ◆ Thời gian mỗi request lý tưởng hoá cho hai dạng workload.
- Prefix caching không làm decode nhanh hơn. Với prompt ngắn và câu trả lời dài, nó gần như không giúp gì.
5. Cái khó: so khớp là chính xác, tính từ token một
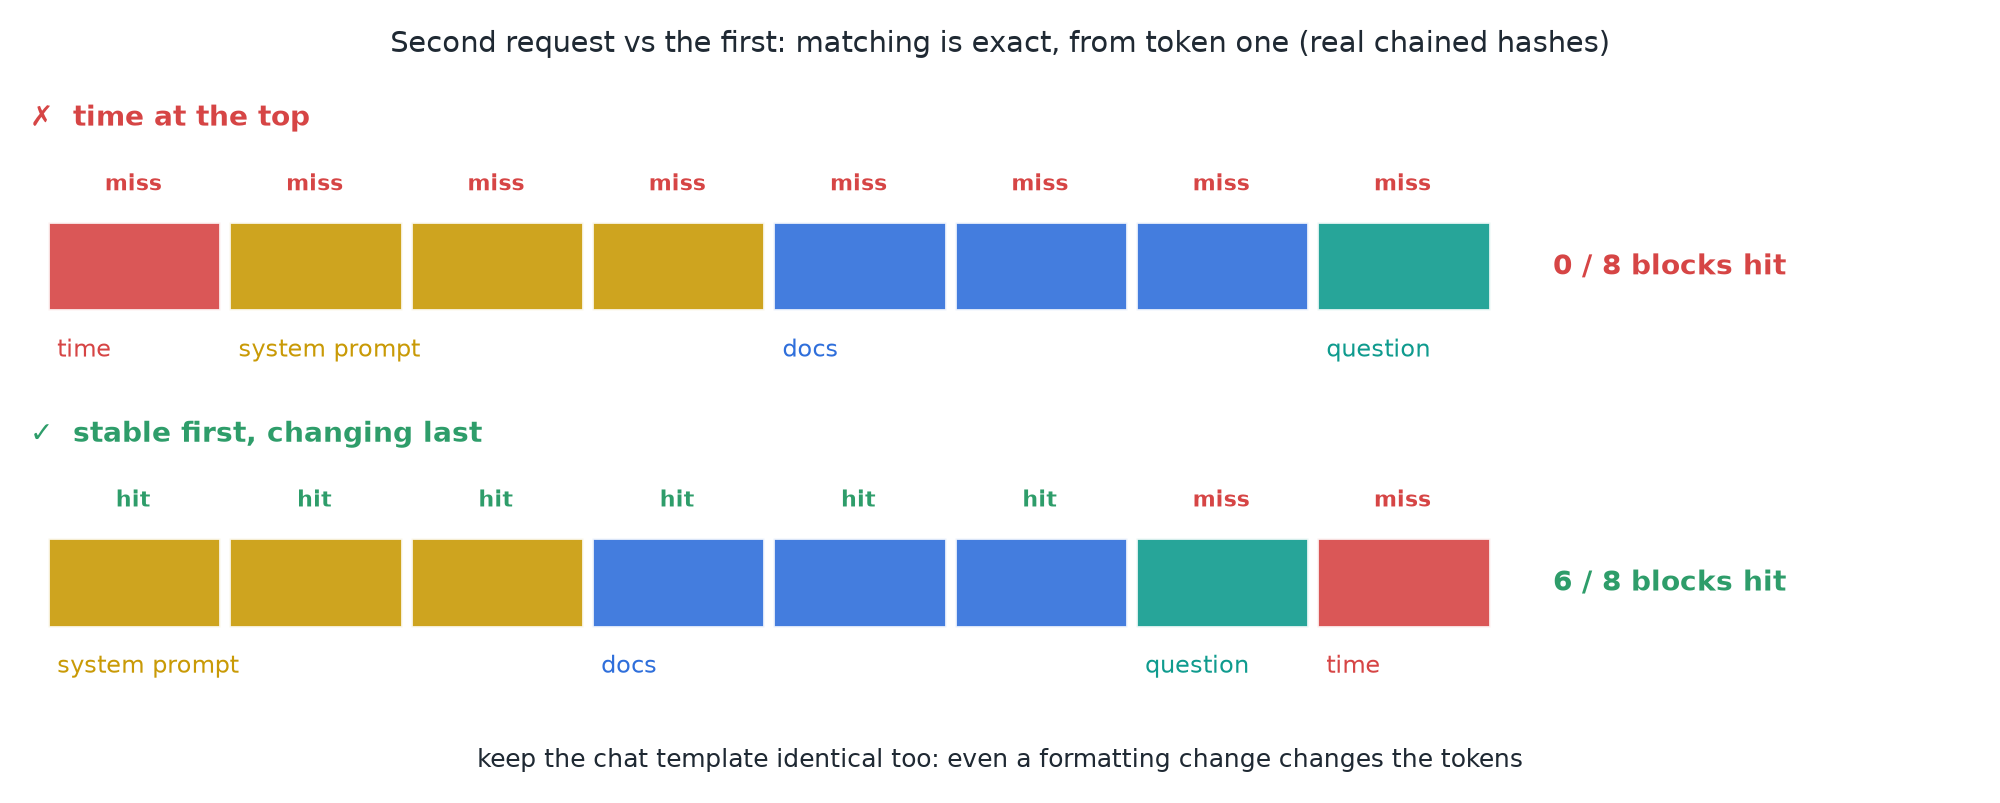 Cùng request thứ hai, hai cách sắp xếp: một khối động ở đầu làm mọi hash phía sau khác đi.
Cảnh báo
Đổi một token gần đầu là mọi hash sau nó đều đổi, vì mỗi hash bao gồm hash trước nó. Một timestamp hay tên người dùng ở đầu âm thầm làm hỏng việc cache cho mọi thứ bên dưới.
Quy tắc:
- Ổn định trước: system prompt, định nghĩa tool, tài liệu dài.
- Thay đổi sau cùng: câu hỏi của người dùng, thời gian hiện tại.
- Giữ chat template giống hệt nhau giữa các request; chỉ đổi định dạng thôi cũng làm token thay đổi.
6. Đo lường, và cách ly tenant
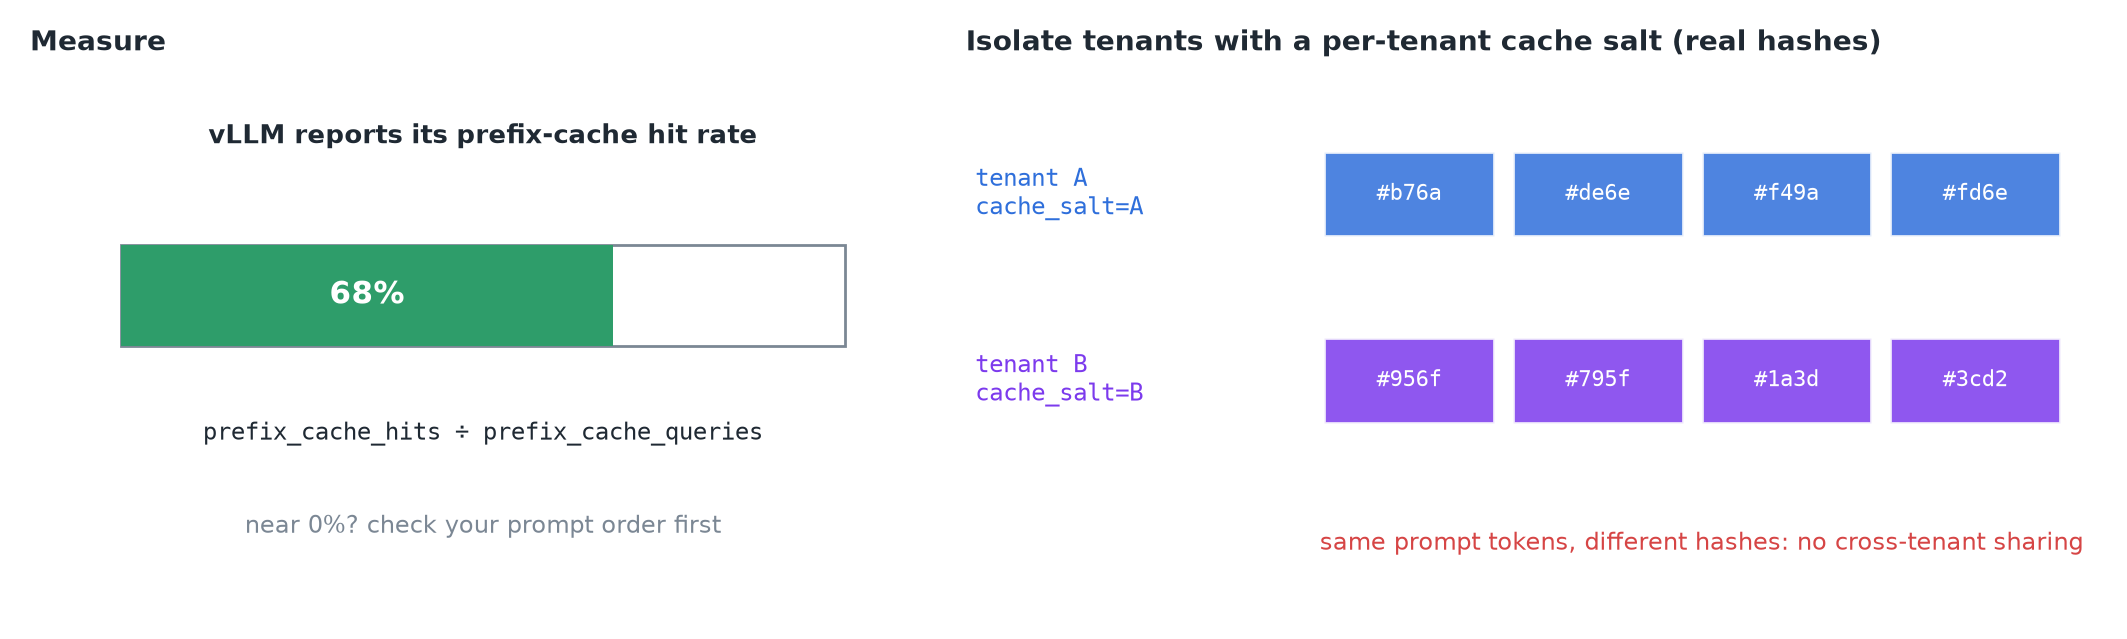 68% mang tính minh hoạ. Hash có salt: cùng token cho ra dấu vân tay khác nhau với mỗi tenant.
- vLLM báo prefix cache hit rate của nó, nên bạn kiểm tra được cache có thực sự hoạt động không.
- Nếu khách hàng không bao giờ được dùng chung cache, hãy cho mỗi tenant một
cache_salt: nó được trộn vào hash, nên prompt giống hệt từ các tenant khác nhau không bao giờ khớp.
7. Tóm tắt