15 · Hiểu và đo pha prefill
Nguồn: fanout.sh / inference-eng / 03-02 · ~6 phút
Ghi chú
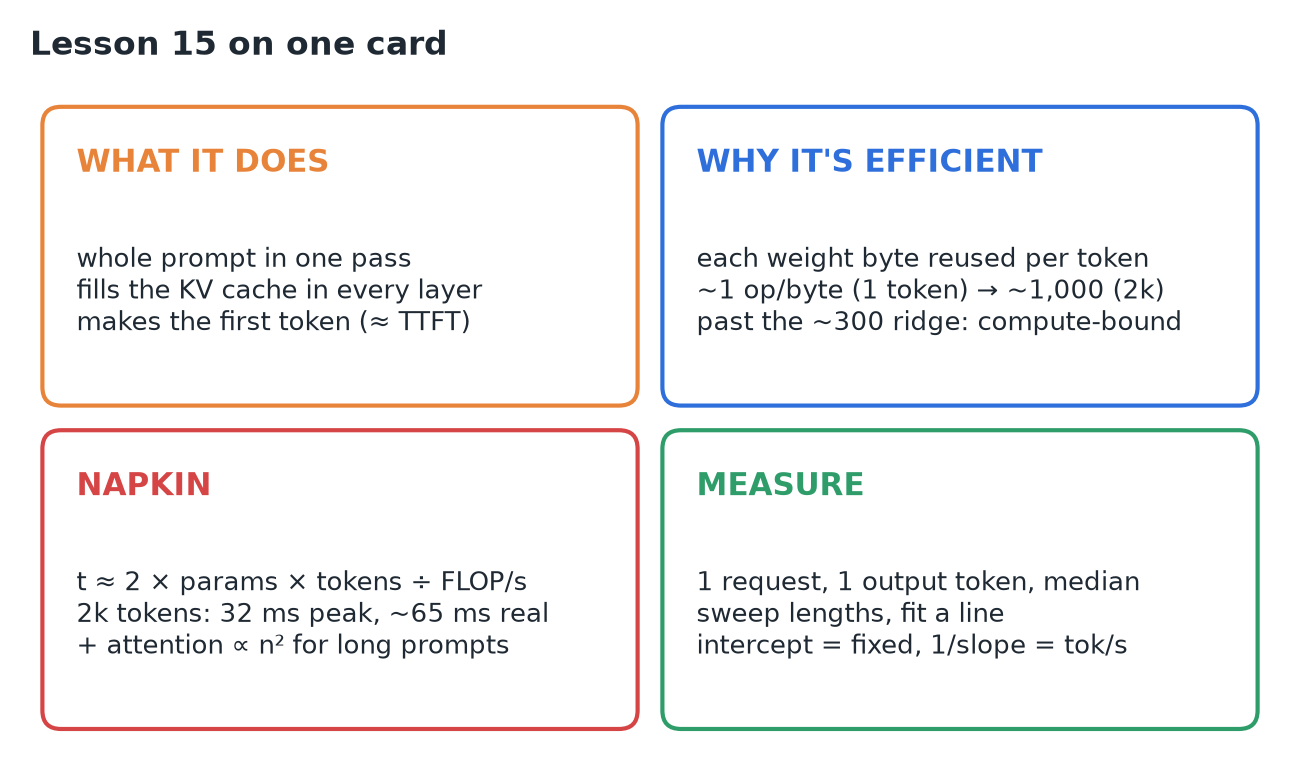
Phần lớn khoảng dừng trước chữ đầu tiên là prefill: một lượt chạy model trên mọi token của prompt cùng lúc, lấp đầy KV cache ở mọi layer và sinh ra token đầu tiên. Vì vậy TTFT ≈ prefill + một chút mạng và xếp hàng. Prefill hiệu quả vì mỗi byte trọng số đọc vào được mọi token của prompt dùng lại: ~1 phép tính/byte với một token, ~400 với 500, ~1.000 với 2.000, vượt qua điểm gãy ~300 của H100, nên nó bị giới hạn bởi tính toán (compute-bound). Ước lượng nhanh: thời gian ≈ 2 × tham số × token ÷ FLOP/s đạt được: 2.000 token trên Llama 3 8B ≈ 32 ms ở mức đỉnh, ~65 ms thực tế (~30 nghìn token/s). Attention thêm một số hạng ∝ n² chỉ đáng kể với prompt dài. Đo nó bằng một request, một token đầu ra, quét theo độ dài và khớp một đường thẳng.
1. Prefill làm gì
Có KV cache, quá trình sinh có hai pha, và prefill là pha đầu. Cả prompt đã biết từ trước, nên không token nào phải chờ token nào: cả 2.000 token chảy qua 32 layer cùng nhau.
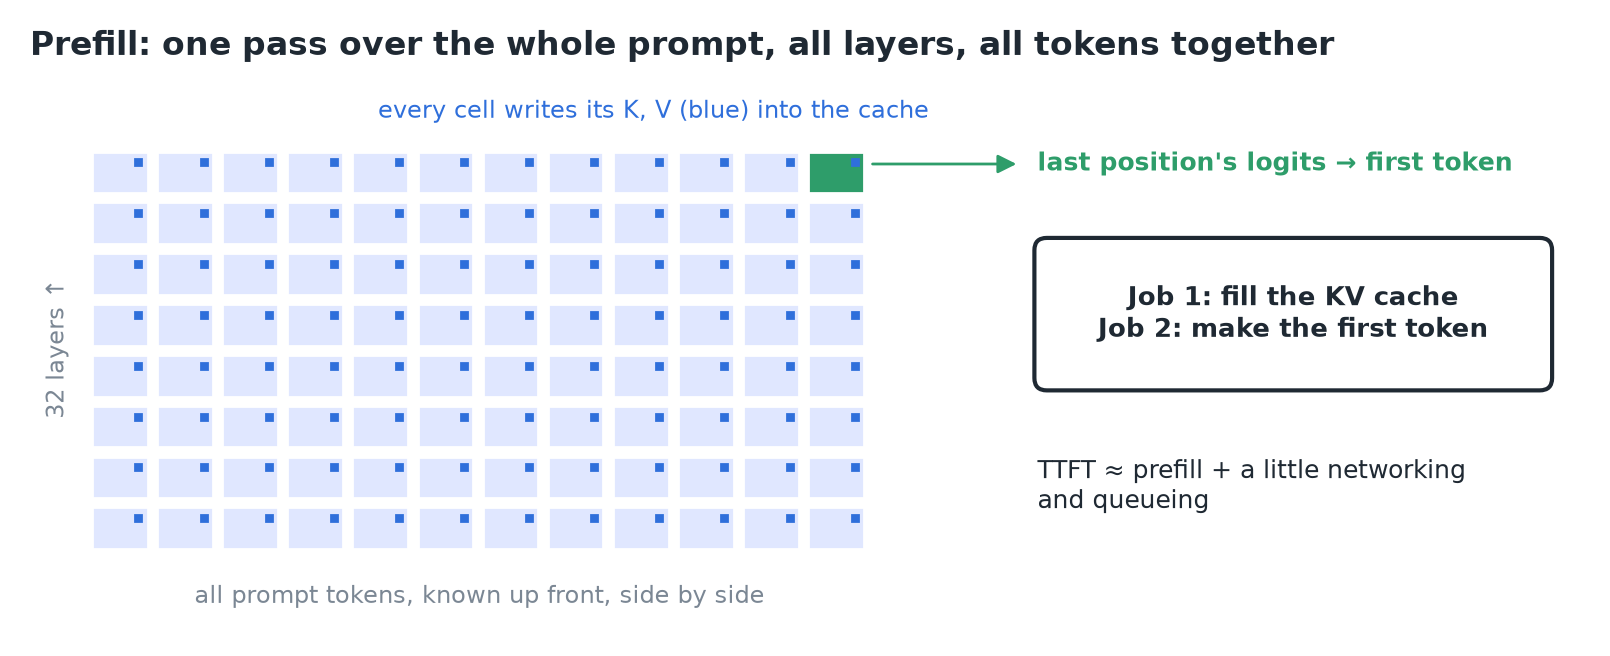 Mỗi layer ghi key và value của mọi token prompt vào cache. Cuối cùng chỉ dùng logits ở vị trí cuối.
Quan trọng
Prefill làm hai việc: lấp đầy cache, và tạo token đầu tiên. Đó là lý do TTFT phần lớn là prefill, cộng một chút mạng và xếp hàng.
2. Vì sao prefill hiệu quả đến vậy
Lấy một ma trận trọng số 4.096 × 4.096: khoảng 34 MB mà GPU phải đọc từ bộ nhớ để dùng.
- Decode: một token đi qua nó. Đọc 34 MB cho một vector công việc nhỏ.
- Prefill: 2.000 token đi qua, và nó chỉ được đọc một lần. Mỗi byte được dùng lại 2.000 lần.
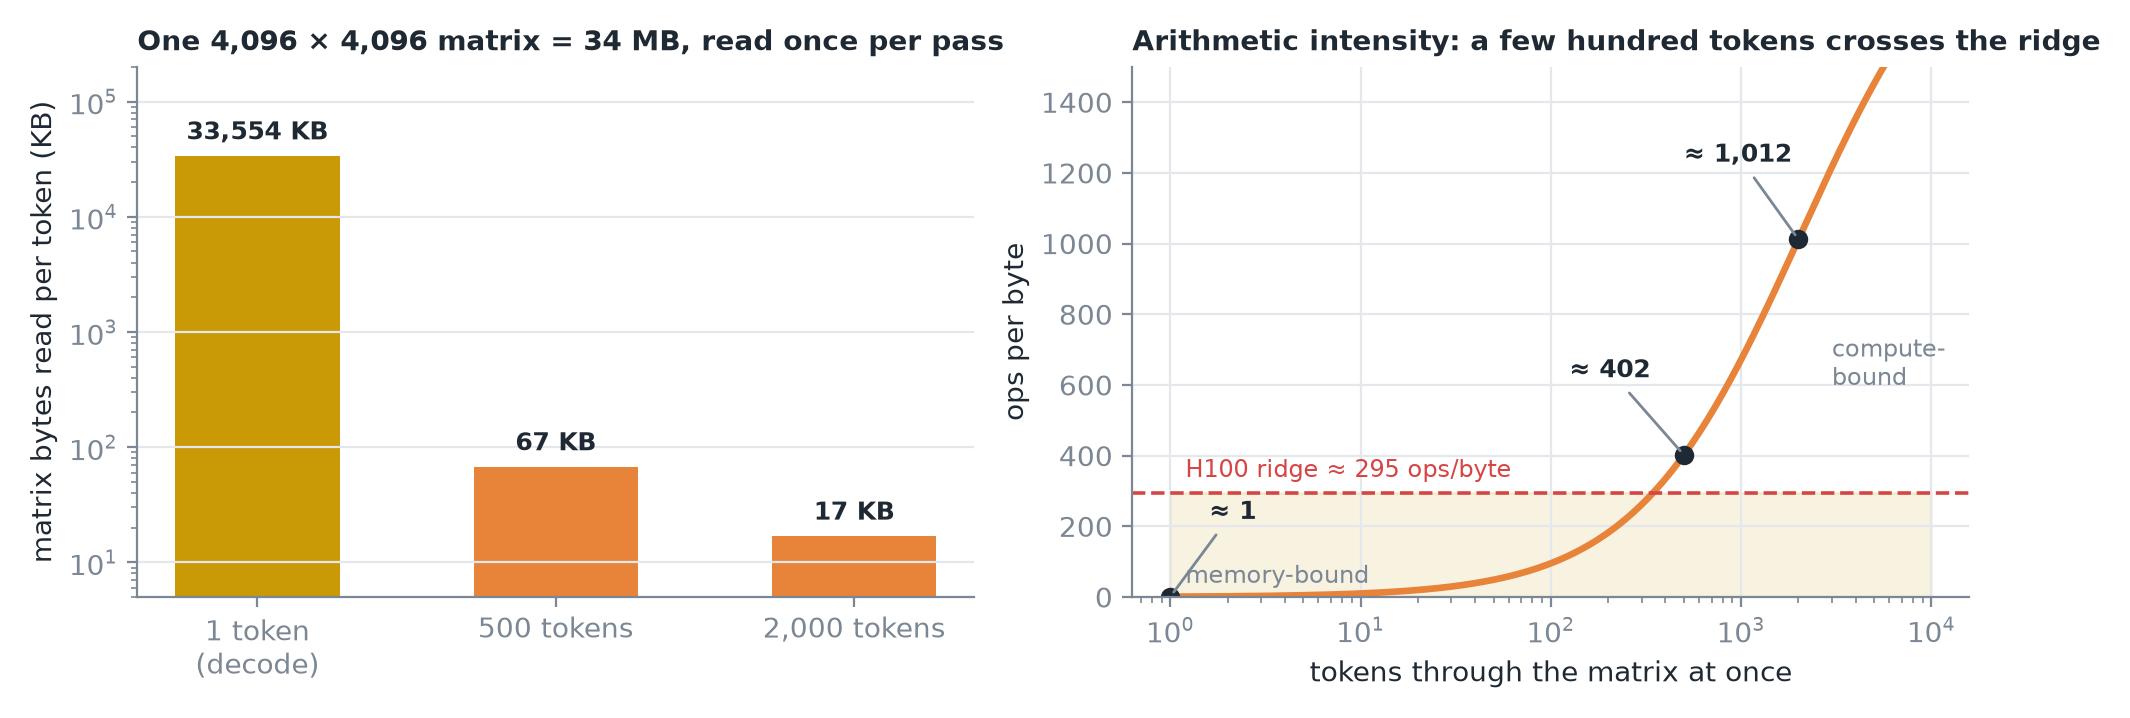 Arithmetic intensity = số phép tính ÷ số byte đọc. Dưới ~300 phép tính/byte, H100 phải chờ bộ nhớ; trên mức đó, đơn vị tính toán là giới hạn.
Mẹo
Một prompt vài trăm token đã đủ để prefill thành compute-bound.
3. Ước lượng nhanh
Một forward pass tốn khoảng 2 phép tính cho mỗi tham số mỗi token.
- Llama 3 8B, prompt 2.000 token: 2 × 8 tỷ × 2.000 ≈ 32 nghìn tỷ phép tính.
- Đỉnh của H100 ≈ 1.000 nghìn tỷ/s (16-bit) → ~32 ms ở mức đỉnh.
- Kernel thật đạt khoảng một nửa đỉnh → kỳ vọng ~65 ms, khoảng 30.000 token prompt/s.
Thêm một số hạng: attention so mỗi token với mọi token trước nó, nên khối lượng của nó tăng theo bình phương độ dài prompt.
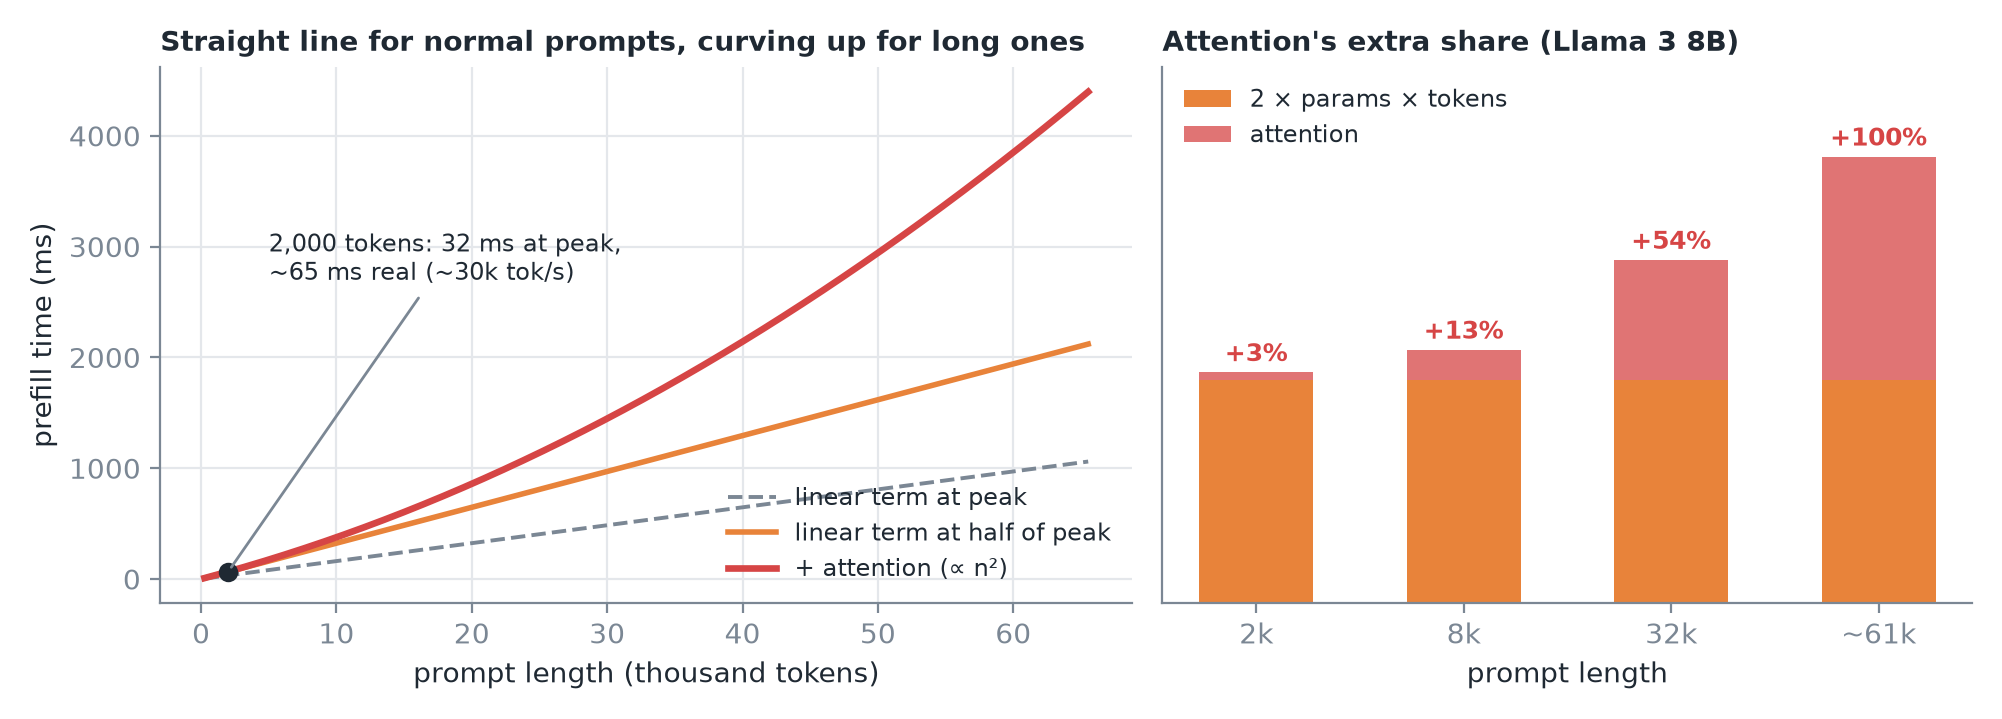 ≈ +3% ở 2k token, thêm hơn một nửa ở 32k, và bằng mọi thứ khác cộng lại ở khoảng 60k. Thời gian prefill là đường thẳng với prompt bình thường, cong lên với prompt rất dài.
4. Đo thật
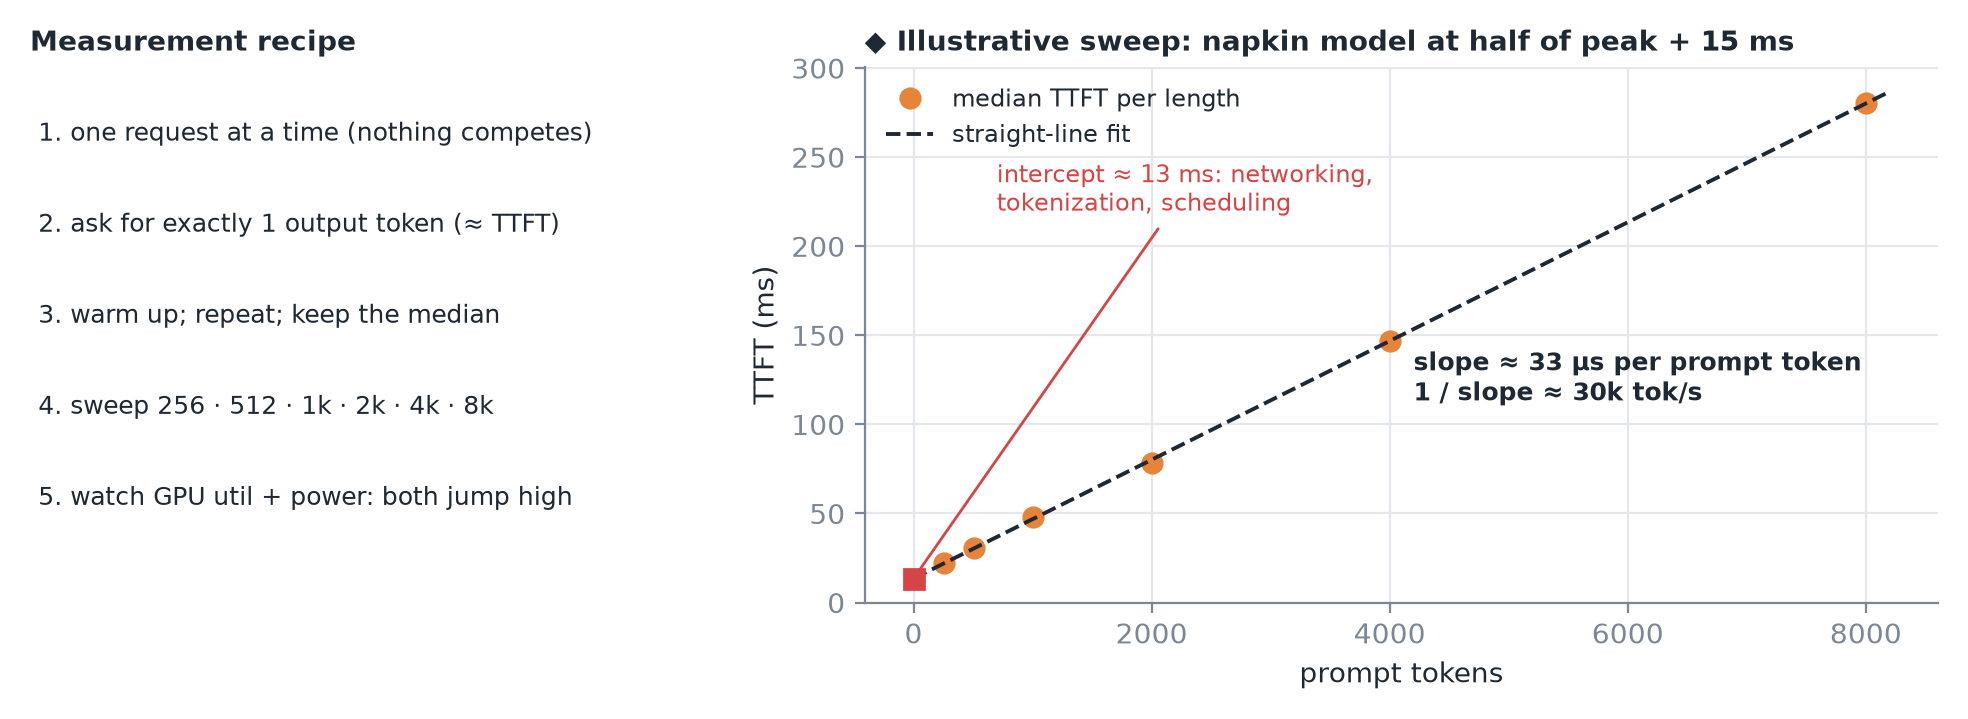 Hệ số chặn là chi phí cố định (mạng, tokenize, lập lịch); độ dốc là thời gian cho mỗi token prompt, và 1 / độ dốc là throughput prefill của bạn.
So kết quả với ước lượng nhanh: thấp hơn nhiều so với một nửa đỉnh nghĩa là có gì đó sai. Theo dõi cả GPU: trong một lượt prefill dài, utilization và công suất tiêu thụ nhảy vọt, dấu hiệu của công việc compute-bound.
5. Vì sao prefill quan trọng trong thực tế
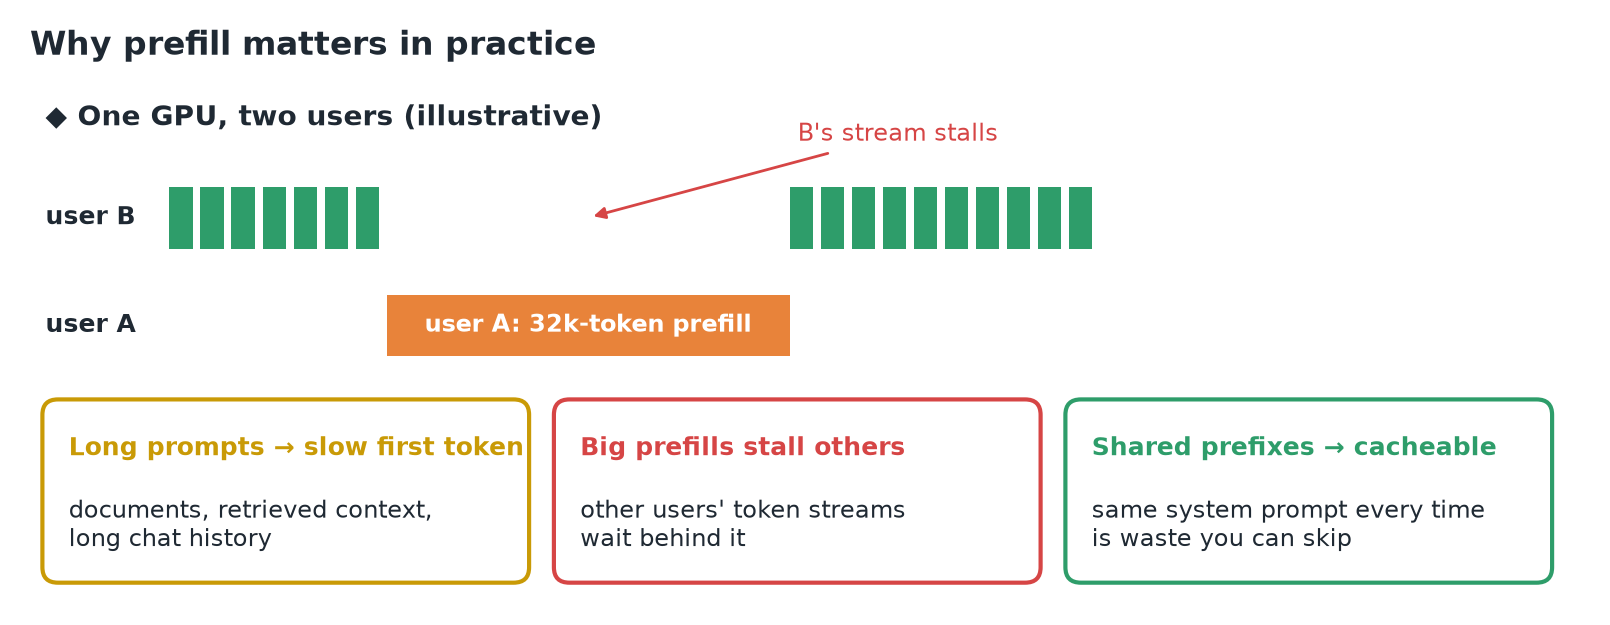 Các cách khắc phục được biết tới là chunked prefill và prefix caching.
6. Tóm tắt