44 · Tái hiện vấn đề nhiễu do prompt dài
Nguồn: fanout.sh / inference-eng / 10-01 · ~4,5 phút
Ghi chú
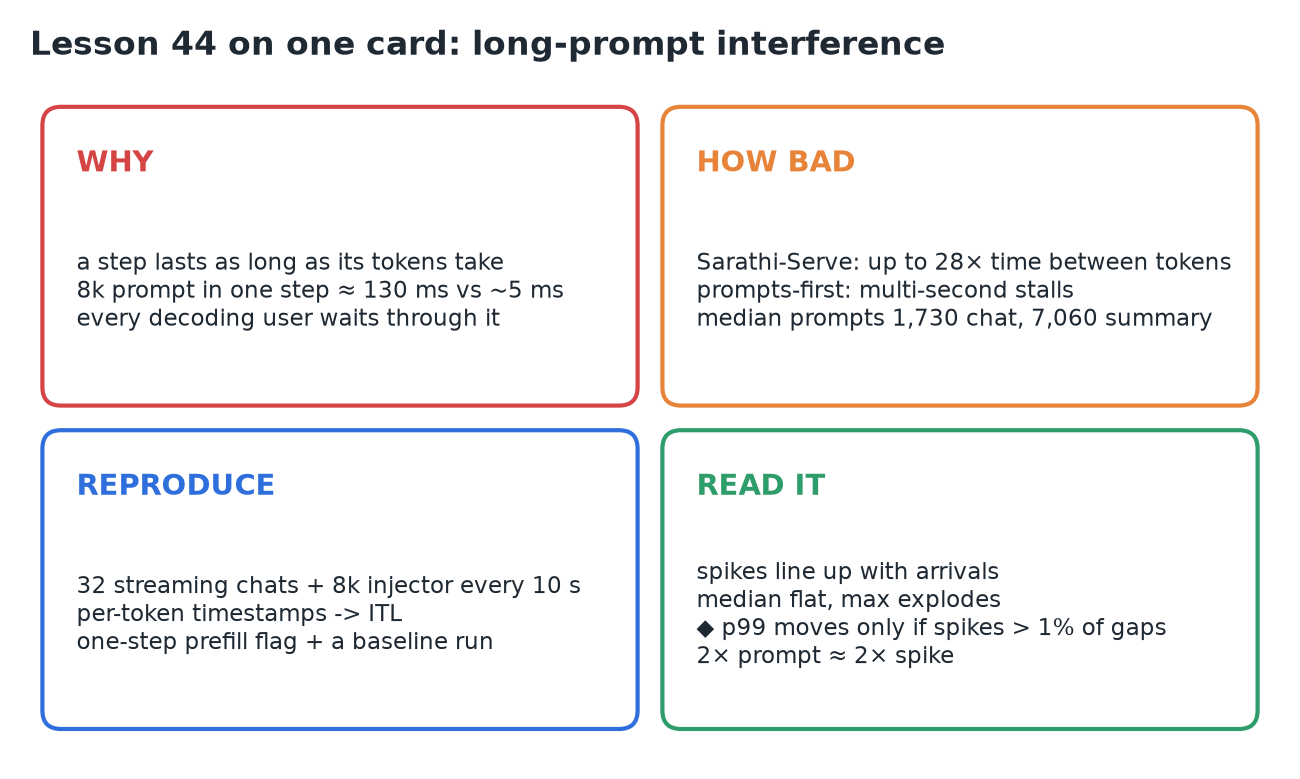
Mỗi request đang chạy nhận một token mỗi bước, và một bước kéo dài bằng thời gian phần việc của nó. Một bước chỉ có decode mất vài mili giây, nhưng một prompt 8.000 token xử lý trong một bước là ≈ 8.000 × 16 GFLOP ≈ 130 ms, và mọi người dùng đang giữa câu trả lời đều phải chờ qua nó. Sarathi-Serve đo được thời gian giữa các token cao tới 28 lần một bước chỉ có decode. Tái hiện nó bằng 32 cuộc chat đang stream, một injector gửi một prompt 8k mỗi 10 s, dấu thời gian cho từng token, cấu hình prefill một bước và một lần chạy baseline. Các đỉnh nhọn khớp với thời điểm prompt đến; trung vị đi ngang trong khi phần đuôi bùng nổ.
1. Vì sao một prompt làm mọi người khựng
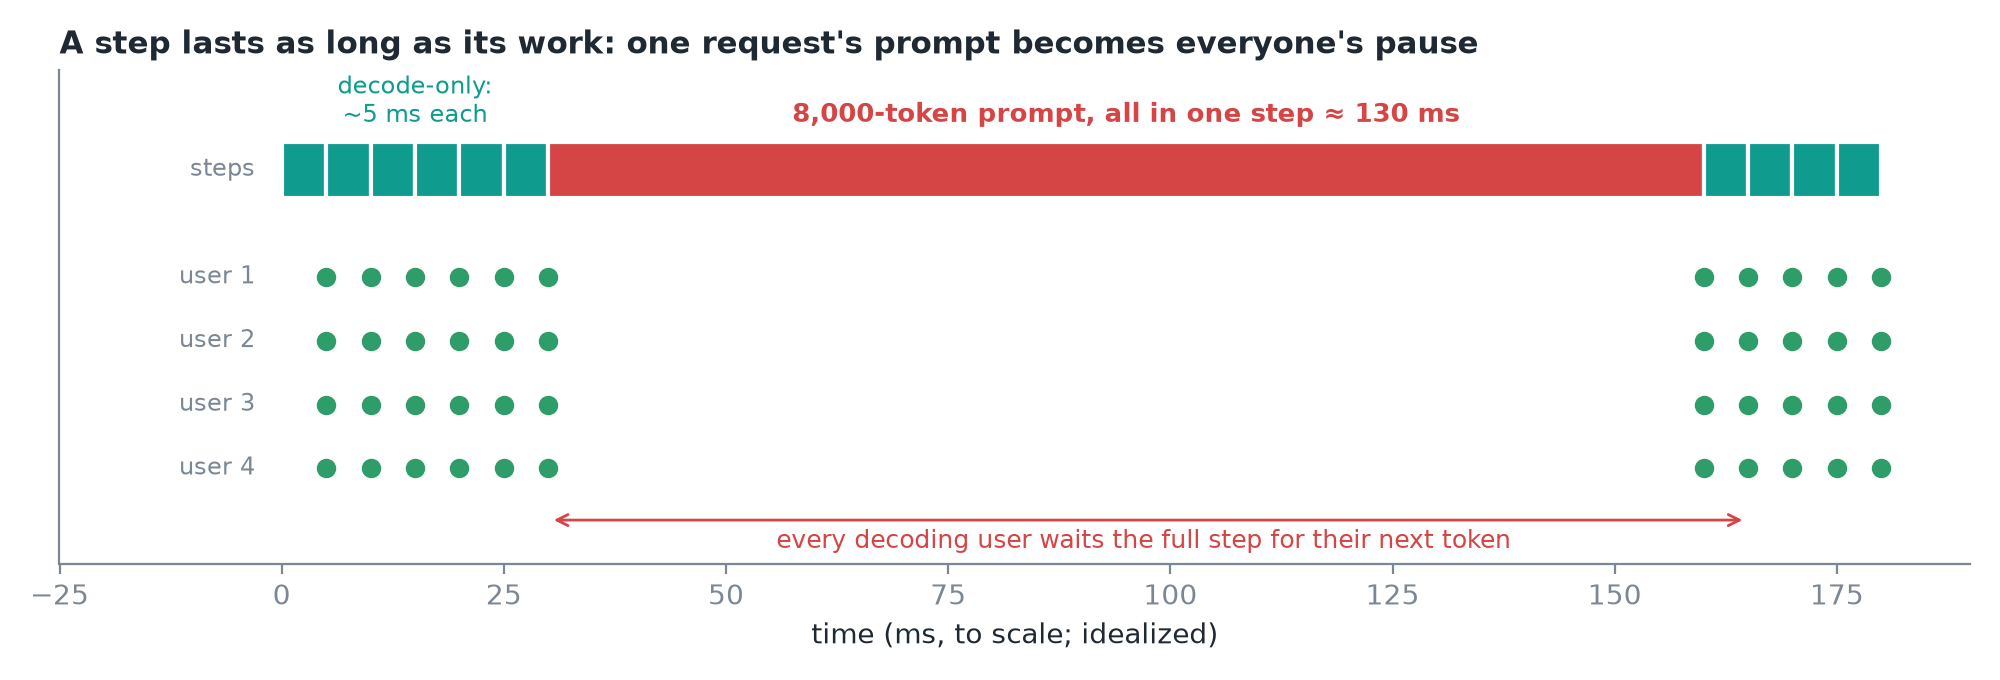 Vẽ đúng tỷ lệ: sáu bước decode 5 ms, rồi một bước 130 ms mang cả prompt.
- Ba mươi người dùng đang stream mượt mà. Một người dán vào một tài liệu dài và yêu cầu tóm tắt. Mọi luồng khác đứng hình, dù không ai khác làm gì khác đi. Đó là nhiễu do prompt dài (long-prompt interference).
- Một bước cho mọi request đang chạy một token, và kéo dài bằng thời gian phần việc của nó.
- Các bước chỉ có decode thì ngắn: vài mili giây với Llama 3.1 8B.
- Một prompt 8.000 token được xử lý toàn bộ trong một bước, và mọi người dùng đang giữa câu trả lời bị kẹt trong cùng bước đó: prompt của một request thành khoảng dừng của mọi người.
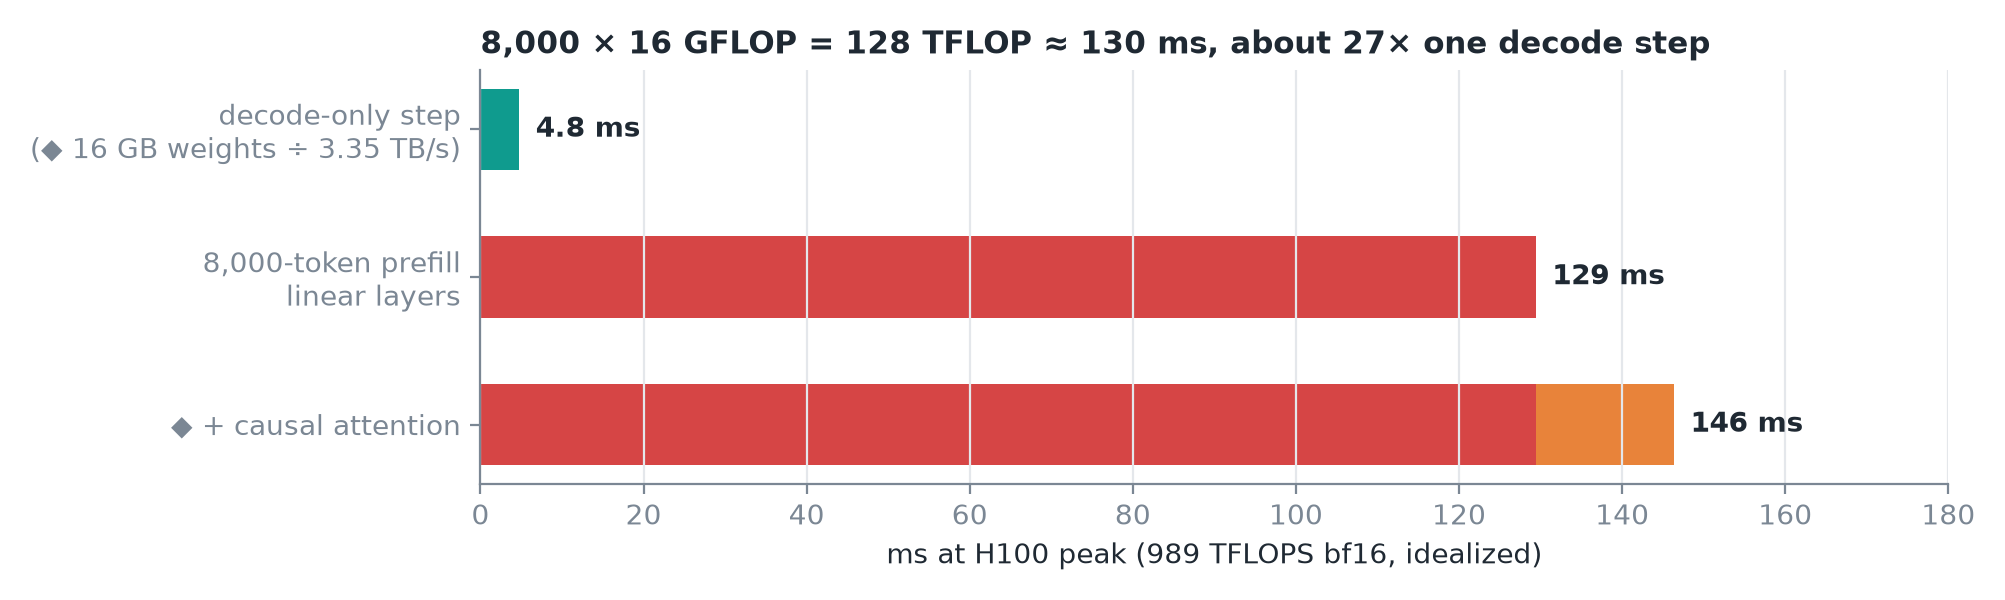 ◆ Thanh decode (trọng số ÷ băng thông) và đoạn attention là phép tính của tôi, không phải của bài.
- Đó là ở mức tính toán đỉnh, chưa tính attention (lý tưởng hoá). ◆ Causal attention trên 8k token thêm ≈ 17 ms, nên ≈ 146 ms: xấp xỉ các đỉnh ≈ 150 ms mà trace của bài cho thấy.
Mẹo
◆ 130 ms ÷ 4,8 ms ≈ 27 lần một bước decode, rất khớp với con số 28 lần Sarathi-Serve đo được.
2. Hệ thống thật tệ tới đâu
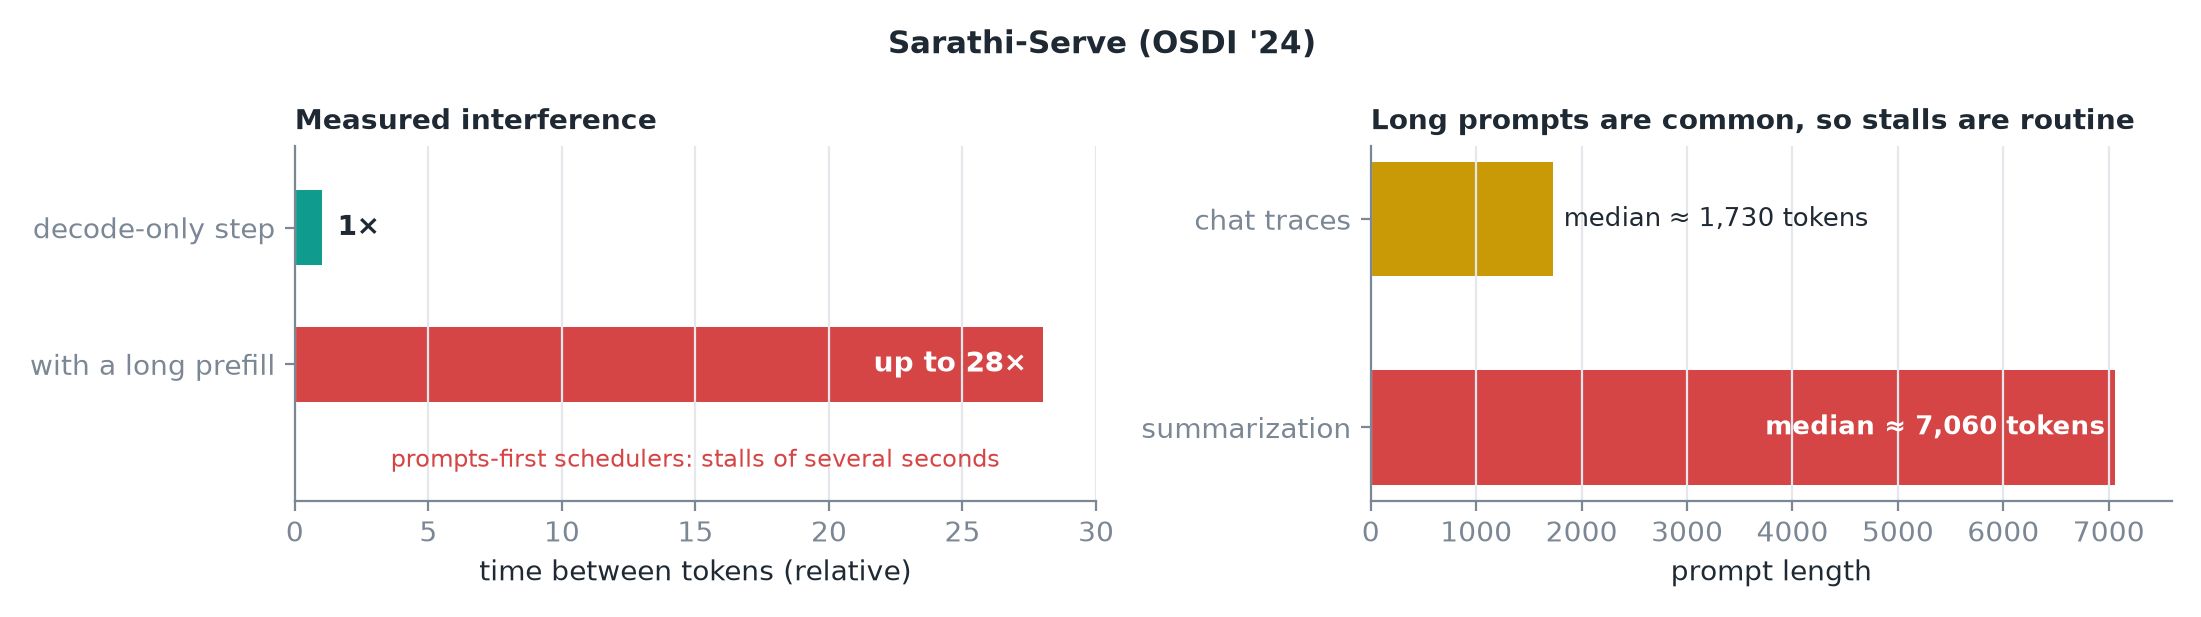 Số liệu từ paper Sarathi-Serve (OSDI '24).
- Trộn một lượt prefill dài vào batch decode làm thời gian giữa các token cao tới 28 lần một bước chỉ có decode.
- Các scheduler chạy mọi prompt đang chờ trước làm các câu trả lời đang diễn ra khựng lại vài giây.
- Prompt dài không hiếm: trung vị prompt ≈ 1.730 token trong trace chat, ≈ 7.060 cho tóm tắt. Với lưu lượng thật, những lần khựng này là chuyện thường ngày.
3. Tái hiện trên server của bạn
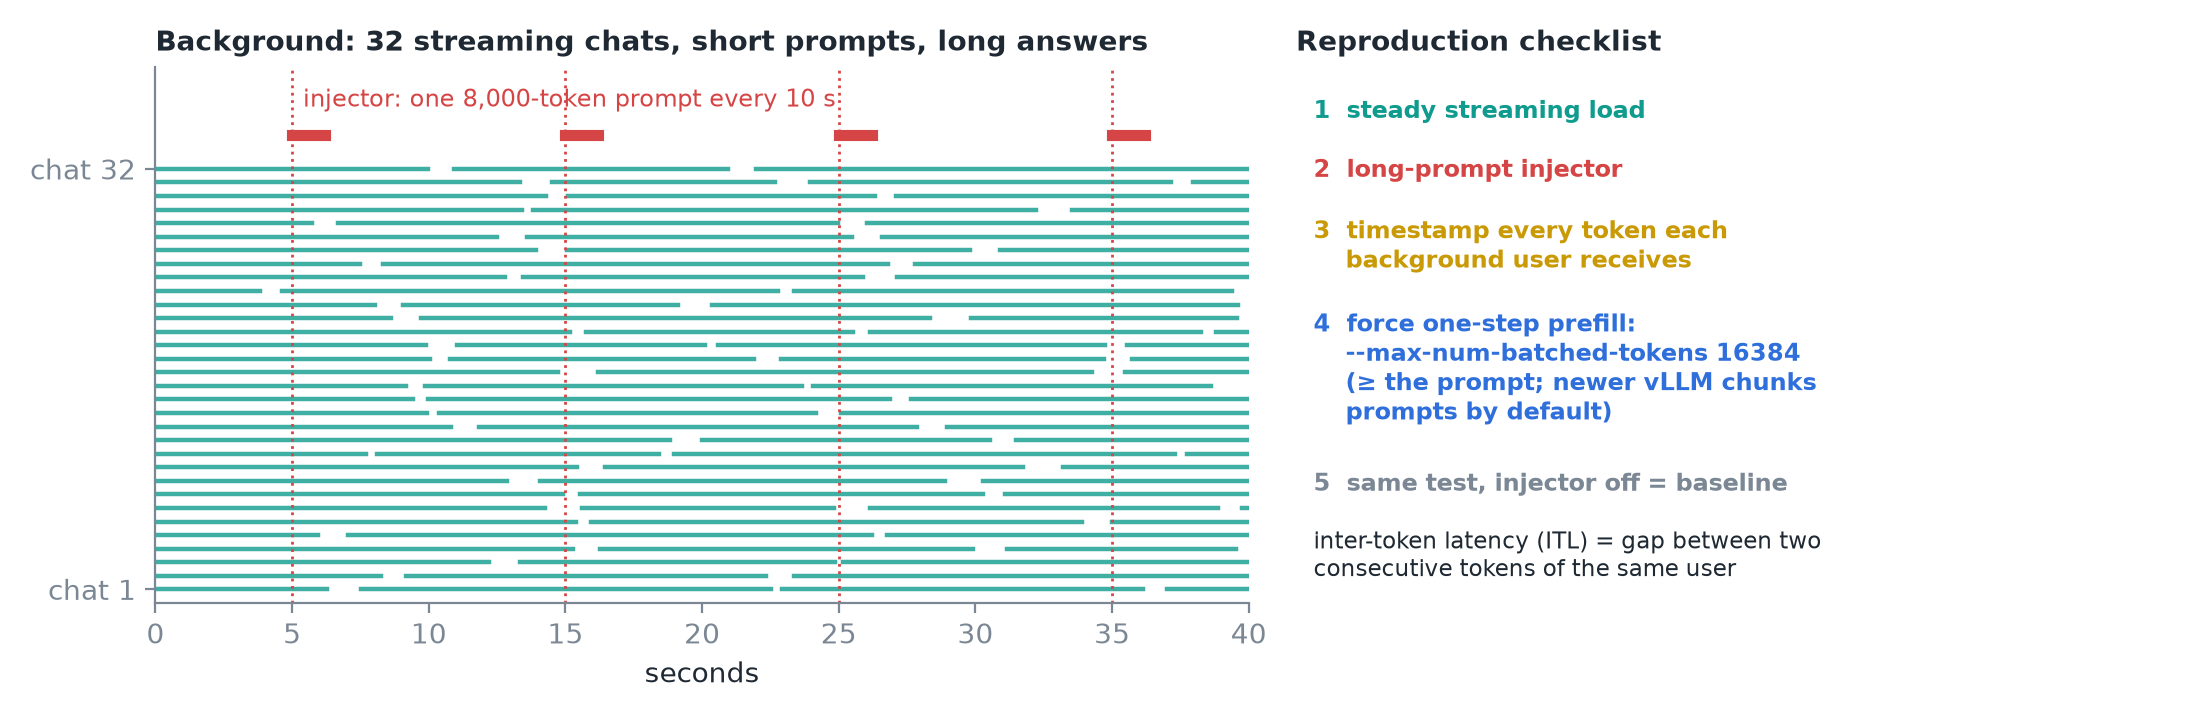 Các làn nền mang tính minh hoạ; injector bắn ở 5, 15, 25 và 35 s.
- Tải nền: 32 cuộc chat đang stream, prompt ngắn, câu trả lời dài.
- Injector: một prompt 8.000 token mỗi 10 s.
- Bộ ghi token: đóng dấu thời gian mọi token mỗi người dùng nền nhận được. Khoảng cách giữa hai token liên tiếp là inter-token latency (ITL).
- Ép prefill một bước: vLLM mới mặc định chia chunk prompt, nên đặt
--max-num-batched-tokensít nhất bằng prompt dài (bài dùng 16384). - Baseline: cùng bài test với injector tắt.
4. Đọc kết quả
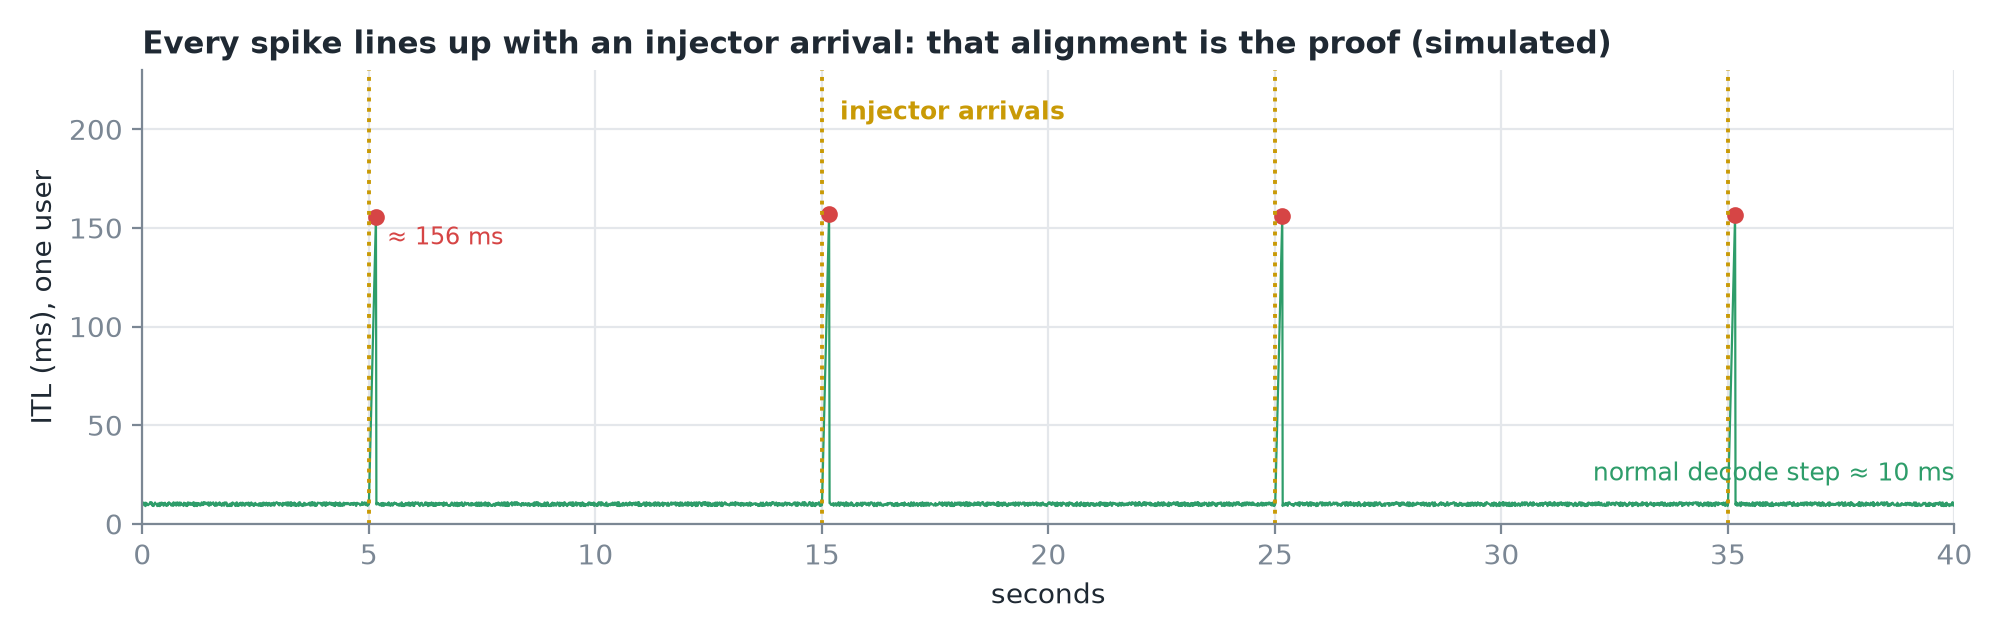 Mô phỏng với bước decode ~10 ms và lượt prefill ≈ 146 ms ở mục 1.
- Phần lớn khoảng cách nằm ở mức bước decode bình thường. Cứ 10 s có một đỉnh cao vút, khớp đúng với một lần injector gửi. Sự trùng khớp đó là bằng chứng prompt dài gây ra các lần khựng.
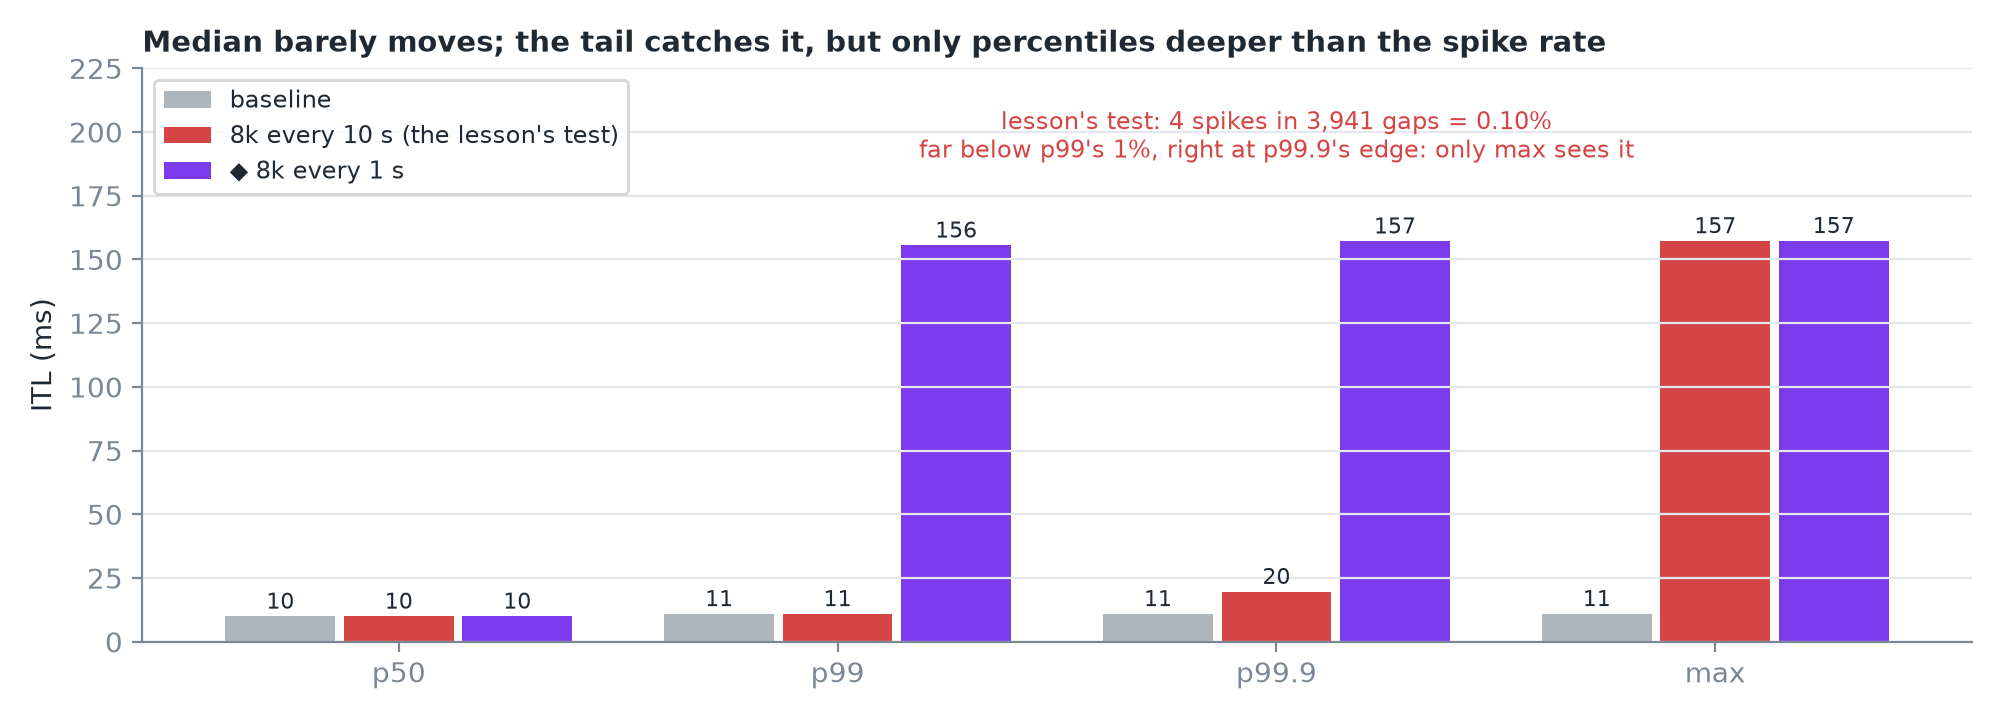 Percentile từ cùng mô phỏng đó. ◆ Lần chạy "mỗi 1 s" là của tôi.
- Trung vị gần như không nhúc nhích so với baseline: phần lớn các bước vẫn bình thường.
- Phần đuôi và giá trị lớn nhất vọt lên. Đó là dấu hiệu nhận biết: trung bình trông ổn, phần đuôi thì tệ hại.
Cảnh báo
Bài học nói p99 vọt lên, nhưng chính bài test của nó không cho ra điều đó. Với bước ~10 ms trong 40 s, mỗi người dùng thấy khoảng 3.940 khoảng cách và chỉ 4 cái là đỉnh nhọn: 0,1%, thấp xa so với 1% mà p99 nhìn vào. Vì vậy p99 vẫn ở mức baseline và chỉ max (và p99.9, vừa đủ) cho thấy nó. Để p99 nhúc nhích, các đỉnh phải chiếm hơn 1% số khoảng cách, ví dụ injector mỗi 1 s. Khi tái hiện, hãy báo max và p99.9, hoặc số lần khựng.
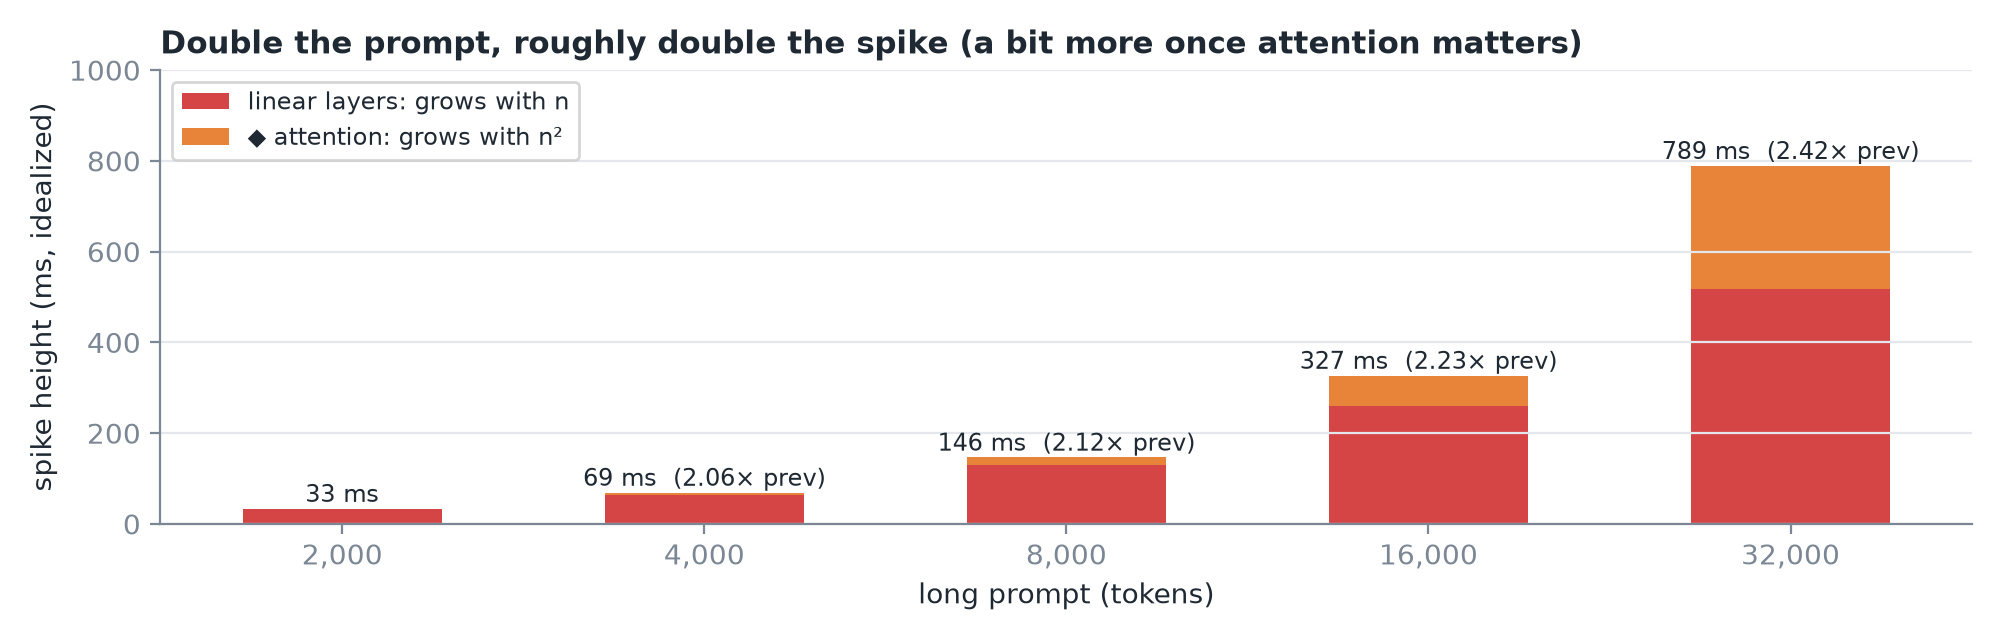 ◆ Mô hình FLOP lý tưởng hoá: linear layer cộng causal attention ở mức đỉnh H100.
- Gấp đôi prompt, và các đỉnh cũng gần như gấp đôi. ◆ Hơi hơn 2 lần một chút khi số hạng n² của attention lớn dần: 2,12 lần từ 4k lên 8k, 2,23 lần từ 8k lên 16k.
5. Tóm tắt